\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Corr}{\operatorname{Corr}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
この記事の範囲
1 本の標本 \(X_1,\dots,X_n\) について、次の検定を扱う。
ある \(\mu\in\R\) 、\(\sigma>0\) について \(X_1,\dots,X_n\iid N(\mu,\sigma^2)\)
正規分布ではない
平均と分散は指定しない(どの正規分布でもよい)。平均と分散を指定した分布への適合を調べるなら、Kolmogorov–Smirnov 検定のほうが直接的である。
このツールの使い方
必要なデータ
標本 \(x\)
数値の列(3〜5,000 点)
並び順は問わない(内部で並べ替える)
前提条件
独立同分布 :観測どうしが独立で、同じ分布に従うこと。時系列の自己相関や、平均の異なるグループの混在があると、正規でないと判定されやすい。連続分布 :丸めた値やタイ(同じ値)が多いと、正規分布からのデータでも棄却されやすい(注意 を参照)。大きさ :3〜5,000 点。p 値の近似(Royston 1995)はこの範囲で検証されている。すべて同じ値だと計算できない。
出力する値
statistic\(W\) (\(0<W\le1\) 。1 に近いほど正規分布らしい)
pvaluep 値(\(W\) が小さいほど小さい)
n, mean, sd標本の大きさ・平均・標準偏差(\(n-1\) で割る)
null_hypothesis帰無仮説
何を示すか
\(W\) は 正規 Q-Q プロットがどれだけ直線に近いか を、順序統計量の一般化最小二乗の考え方で測る量である。 ここでは定義から次を示す。
\(W\) は位置と尺度を変えても変わらず、係数ベクトルと順序統計量の相関係数の 2 乗である(したがって \(W\le1\) )。帰無仮説のもとで \(W\) は \((\bar X,S^2)\) と独立である。\(W\) の分布は \(\mu,\sigma\) によらない。
\(n=3\) のとき \(W\) の分布は厳密に求まり、\(P(W\le w)=\frac6\pi\big(\arcsin\sqrt w-\frac\pi3\big)\) である。
\(n\ge4\) の分布は閉じた形にならない。API とサイトの計算で使う Royston (1995) の近似を示し、有意水準が守られていることと検出力をシミュレーションで確かめる。
W の定義
順序統計量の線形モデル
\(X_i=\mu+\sigma Z_i\) 、\(Z_i\iid N(0,1)\) とし、並べ替えたものを \(X_{(1)}\le\dots\le X_{(n)}\) 、\(Z_{(1)}\le\dots\le Z_{(n)}\) と書く。 \(\sigma>0\) なので並べ替えと 1 次変換は入れ替えられ、\(X_{(i)}=\mu+\sigma Z_{(i)}\) である。 標準正規の順序統計量の平均と共分散を \[
m_i=\E Z_{(i)},\qquad V_{ij}=\Cov\big(Z_{(i)},Z_{(j)}\big)
\] とおくと、\(\boldsymbol x=(X_{(1)},\dots,X_{(n)})^\top\) は \[
\boldsymbol x=\mu\boldsymbol 1+\sigma\boldsymbol m+\boldsymbol\varepsilon,\qquad \E\boldsymbol\varepsilon=\boldsymbol 0,\quad \Var\boldsymbol\varepsilon=\sigma^2V
\] という(誤差が相関する)線形モデルに従う。点 \((m_i,X_{(i)})\) を並べたものが正規 Q-Q プロットで、このモデルは「Q-Q プロットは傾き \(\sigma\) の直線のまわりに散らばる」ことを表す。
対称性
\(-Z_1,\dots,-Z_n\) も \(N(0,1)\) に独立に従い、その \(i\) 番目に小さい値は \(-Z_{(n+1-i)}\) である。したがって \[
\big(Z_{(1)},\dots,Z_{(n)}\big)\overset{d}{=}\big(-Z_{(n)},\dots,-Z_{(1)}\big).
\] 並びを逆にする行列を \(J\) (\(J_{ij}=1\iff i+j=n+1\) )とすると、これから \(J\boldsymbol m=-\boldsymbol m\) 、\(JVJ=V\) が従う。 特に \(\boldsymbol 1^\top\boldsymbol m=\boldsymbol 1^\top J\boldsymbol m=-\boldsymbol 1^\top\boldsymbol m\) より \(\boldsymbol 1^\top\boldsymbol m=0\) 。
σ の最良線形不偏推定量と W
一般化最小二乗(Lloyd 1952)による \(\sigma\) の最良線形不偏推定量は、\(\boldsymbol 1^\top V^{-1}\boldsymbol m=0\) (下の補題)のもとで \[
\hat\sigma=\frac{\boldsymbol m^\top V^{-1}\boldsymbol x}{\boldsymbol m^\top V^{-1}\boldsymbol m}
\] となる。これを正規化した係数 \[
\boldsymbol a=\frac{V^{-1}\boldsymbol m}{\big\|V^{-1}\boldsymbol m\big\|}\qquad(\|\boldsymbol a\|=1)
\] を使い、Shapiro and Wilk (1965) は \[
W=\frac{\big(\sum_{i=1}^n a_iX_{(i)}\big)^2}{\sum_{i=1}^n(X_i-\bar X)^2}
\] と定義した。分子は \(\hat\sigma^2\) の定数倍、分母は \((n-1)S^2\) で、どちらも正規分布のもとでは \(\sigma^2\) の推定量である。 正規分布でなければ Q-Q プロットが曲がり、分子(直線の傾きから求めた尺度)が分母より小さくなる。
補題. \(J\boldsymbol a=-\boldsymbol a\) 。特に \(a_i=-a_{n+1-i}\) 、\(\sum_ia_i=0\) 。
証明. \(J^2=I\) と \(JVJ=V\) から \(JV^{-1}J=V^{-1}\) 、すなわち \(JV^{-1}=V^{-1}J\) 。よって \(JV^{-1}\boldsymbol m=V^{-1}J\boldsymbol m=-V^{-1}\boldsymbol m\) 。 \(\boldsymbol 1^\top\boldsymbol a=\boldsymbol 1^\top J\boldsymbol a=-\boldsymbol 1^\top\boldsymbol a\) (\(J\boldsymbol1=\boldsymbol1\) )より和は 0。\(\square\)
定理 1(不変性と相関係数による表現)
\(c\in\R\) 、\(b>0\) について、\(X_i\) を \(c+bX_i\) に置き換えても \(W\) は変わらない。\(W\) は \((a_1,\dots,a_n)\) と \((X_{(1)},\dots,X_{(n)})\) の相関係数の 2 乗である。したがって \(0\le W\le1\) 。
証明. 1. \(b>0\) なので順序統計量は \(c+bX_{(i)}\) になる。補題より \(\sum_ia_i(c+bX_{(i)})=b\sum_ia_iX_{(i)}\) 、分母は \(b^2\) 倍になるので比は変わらない。
\(\sum_ia_i=0\) だから \(\sum_ia_iX_{(i)}=\sum_ia_i(X_{(i)}-\bar X)\) 、また \(\sum_i(X_i-\bar X)^2=\sum_i(X_{(i)}-\bar X)^2\) 。\(\sum_ia_i^2=1\) 、\(\bar a=0\) より \[
W=\frac{\big(\sum_i(a_i-\bar a)(X_{(i)}-\bar X)\big)^2}{\sum_i(a_i-\bar a)^2\,\sum_i(X_{(i)}-\bar X)^2}=\Corr\big(\boldsymbol a,\boldsymbol x\big)^2 .
\] Cauchy–Schwarz の不等式から \(W\le1\) 。\(\square\)
等号 \(W=1\) は \(X_{(i)}\) が \(a_i\) の 1 次式のときに限る。下限は \(W\ge na_1^2/(n-1)\) である(Shapiro and Wilk 1965, 補題 1)。
定理 2(\((\bar X,S^2)\) との独立性)
帰無仮説のもとで、\(W\) の分布は \((\mu,\sigma)\) によらず、\(W\) は \((\bar X,S^2)\) と独立である。
証明. 定理 1 の 1 で \(c=-\mu/\sigma\) 、\(b=1/\sigma\) とすると \(W(X_1,\dots,X_n)=W(Z_1,\dots,Z_n)\) で、右辺の分布は母数を含まない(\(W\) は補助統計量)。 一方 \((\bar X,S^2)\) は正規分布族 \(\{N(\mu,\sigma^2)^{\otimes n}\}\) の完備十分統計量である(2 母数の指数型分布族で、自然母数の空間が \(\R^2\) の開集合を含む)。 Basu の定理(t 検定の記事 の定理 C)により、補助統計量は完備十分統計量と独立である。\(\square\)
系. \(\big(\sum_ia_iX_{(i)}\big)^2=W\cdot(n-1)S^2\) の右辺の 2 つの因子は独立なので、\(k=1,2,\dots\) について \[
\E W^k=\frac{\E\big(\sum_ia_iX_{(i)}\big)^{2k}}{\E\big((n-1)S^2\big)^k} .
\] \(k=1\) では \(\E(\boldsymbol a^\top\boldsymbol x)^2=\sigma^2\big(\boldsymbol a^\top V\boldsymbol a+(\boldsymbol a^\top\boldsymbol m)^2\big)\) (\(\boldsymbol a^\top\boldsymbol 1=0\) )、\(\E(n-1)S^2=(n-1)\sigma^2\) より \[
\E W=\frac{\boldsymbol a^\top V\boldsymbol a+(\boldsymbol a^\top\boldsymbol m)^2}{n-1} .
\] 比の期待値が期待値の比になるのは独立性のおかげで、Shapiro and Wilk (1965) はこの方法で \(W\) の低次のモーメントを求めた。
定理 3(\(n=3\) の厳密な分布)
\(n=3\) のとき \(\boldsymbol a=(-1/\sqrt2,\,0,\,1/\sqrt2)\) で、帰無仮説のもとで \(W\) は \([3/4,1]\) に値をとり \[
P(W\le w)=\frac6\pi\Big(\arcsin\sqrt w-\frac\pi3\Big),\qquad \frac34\le w\le1 .
\]
証明. 補題より \(a_2=0\) 、\(a_3=-a_1\) 、\(\|\boldsymbol a\|=1\) から \(\boldsymbol a\) は上の形で、\(W=(X_{(3)}-X_{(1)})^2/\big(2\sum_i(X_i-\bar X)^2\big)\) である。定理 2 より \(\mu=0,\sigma=1\) としてよい。
残差 \(\boldsymbol e=(X_i-\bar X)_i\) は \(\boldsymbol 1\) に直交する平面 \(P\) への \(\boldsymbol Z\) の直交射影である。標準正規ベクトルの分布は回転で不変なので、\(\boldsymbol e/\|\boldsymbol e\|\) は \(P\) の単位円上で一様に分布する。 \(P\) の単位円は \[
\boldsymbol e/\|\boldsymbol e\|=\sqrt{\tfrac23}\,\big(\cos\theta,\ \cos(\theta-\tfrac{2\pi}3),\ \cos(\theta+\tfrac{2\pi}3)\big),\qquad \theta\in[0,2\pi)
\] と書ける(3 つの余弦の和は 0、2 乗和は \(3/2\) )ので、\(\theta\) は \([0,2\pi)\) 上の一様分布に従う。
\(W\) は \(\boldsymbol e\) の成分の並べ替えで変わらず、成分の入れ替えは \(\theta\mapsto\theta\pm\frac{2\pi}3\) と \(\theta\mapsto-\theta\) に対応する。これらで \([0,2\pi)\) は長さ \(\pi/3\) の 6 つの区間に移り合うので、\(\theta\in[0,\pi/3]\) で一様としてよい。 この区間では最大の成分が \(\cos\theta\) 、最小の成分が \(\cos(\theta+\frac{2\pi}3)\) で、 \[
\cos\theta-\cos\big(\theta+\tfrac{2\pi}3\big)=2\sin\big(\theta+\tfrac\pi3\big)\sin\tfrac\pi3=\sqrt3\,\sin\big(\theta+\tfrac\pi3\big),
\qquad
W=\frac{\tfrac23\cdot3\sin^2(\theta+\frac\pi3)}{2}=\sin^2\varphi,
\] ただし \(\varphi=\theta+\frac\pi3\) は \([\frac\pi3,\frac{2\pi}3]\) 上の一様分布に従う。\(\sin^2\) は \(\varphi=\frac\pi2\) について対称なので \(\varphi\in[\frac\pi3,\frac\pi2]\) で一様としてよく、そこで \(\sin\) は増加する。よって \[
P(W\le w)=P\big(\varphi\le\arcsin\sqrt w\big)=\frac{\arcsin\sqrt w-\pi/3}{\pi/2-\pi/3}=\frac6\pi\Big(\arcsin\sqrt w-\frac\pi3\Big).\qquad\square
\]
\(W\) が小さいほど正規分布から遠いので、p 値は \(P(W\le w_{\text{obs}})\) である。\(n=3\) では API もこの式で p 値を計算する。
係数と p 値の計算(Royston の近似)
\(n\ge4\) では \(\boldsymbol m\) と \(V\) を厳密に求めるのが難しく、Shapiro and Wilk (1965) は \(n\le50\) の係数と分位点を表で与えた。 API は、R の shapiro.test と scipy の shapiro と同じ Royston (1992, 1995) の近似(AS R94) を使う。
係数. \(m_i\) を Blom の近似 \(\tilde m_i=\Phi^{-1}\big((i-\frac38)/(n+\frac14)\big)\) で置き換え、\(\boldsymbol a\approx\tilde{\boldsymbol m}/\|\tilde{\boldsymbol m}\|\) とする(\(V^{-1}\) を省いた形で、中央付近の係数はこれで十分正確)。 誤差が大きい両端の係数だけを \(u=1/\sqrt n\) の 5 次多項式で補正し、 \[
a_n=\tilde c_n+0.221157u-0.147981u^2-2.071190u^3+4.434685u^4-2.706056u^5,
\] \(n>5\) ではさらに \(a_{n-1}\) も同様に補正する(\(\tilde c_i=\tilde m_i/\|\tilde{\boldsymbol m}\|\) )。残りの係数は \(\|\boldsymbol a\|=1\) となるよう定数倍し、補題どおり \(a_i=-a_{n+1-i}\) とする。 \(\Phi^{-1}\) には Wichura (1988) の AS241(相対誤差 \(10^{-16}\) 程度)を使う。
p 値. \(1-W\) の対数を正規分布で近似する。
4〜11
\(-\log\big(\gamma-\log(1-W)\big)\) 、\(\gamma=-2.273+0.459n\) \(0.5440-0.39978n+0.025054n^2-0.0006714n^3\) \(\exp(1.3822-0.77857n+0.062767n^2-0.0020322n^3)\)
12〜5000
\(\log(1-W)\) \(-1.5861-0.31082\ell-0.083751\ell^2+0.0038915\ell^3\) \(\exp(-0.4803-0.082676\ell+0.0030302\ell^2)\)
(\(\ell=\log n\) )とし、p 値は \(P\big(N(\mu_n,\sigma_n^2)>y\big)\) 。\(n\le11\) で \(\log(1-W)\ge\gamma\) となる極端な場合は、近似の範囲外なので R・scipy と同じく p 値を \(10^{-99}\) とする。 \(1-W\) は、\(s_a=\sum_i(a_i-\bar a)^2\) 、\(s_x=\sum_i(X_{(i)}-\bar X)^2\) 、\(s_{ax}=\sum_i(a_i-\bar a)(X_{(i)}-\bar X)\) として(定理 1 の 2)\(\big(\sqrt{s_as_x}-s_{ax}\big)\big(\sqrt{s_as_x}+s_{ax}\big)/(s_as_x)\) の形で直接求め、\(W\approx1\) での桁落ちを避けている。
API の結果は scipy と 2003 項目(\(n=3\) 〜\(5000\) 、正規・t・一様・指数・対数正規・タイの多いデータ・平均が大きく分散が小さいデータ)で、相対誤差 \(10^{-9}\) 以内で一致することを確かめている。
有意水準は守られるか
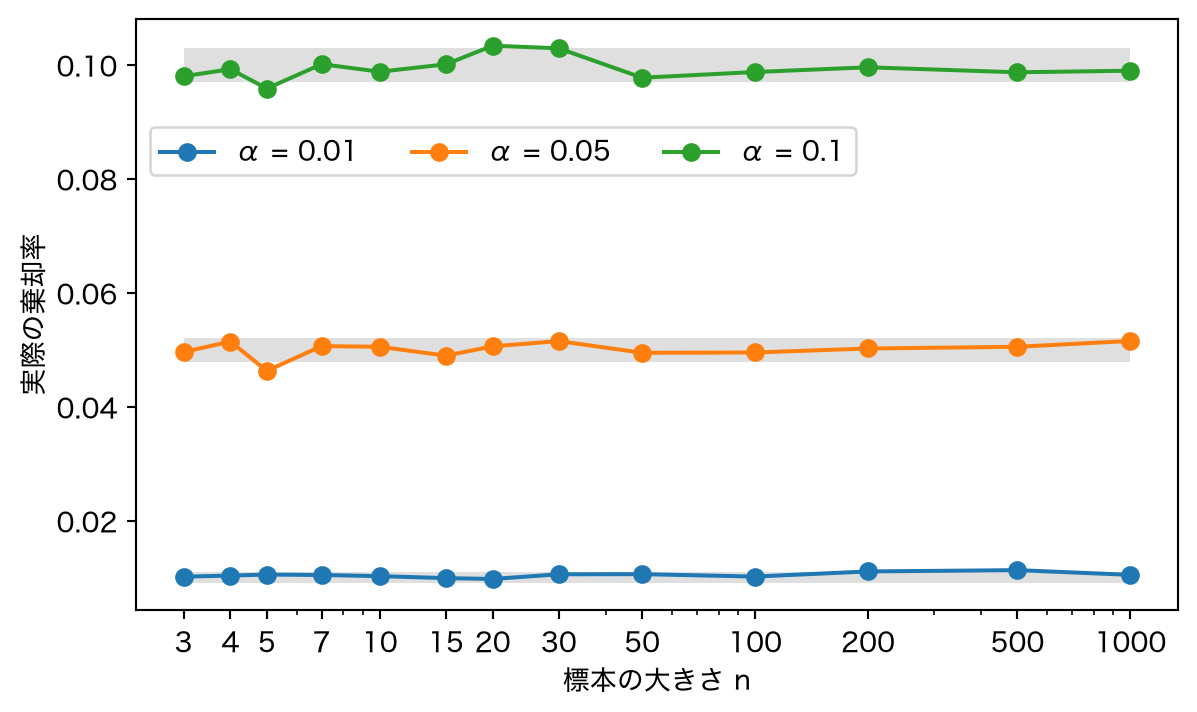
近似がうまくいっていれば、帰無仮説のもとで p 値は一様分布に従い、棄却率は有意水準に一致する。
コード
import numpy as npimport matplotlib.pyplot as pltfrom scipy import stats"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(0 )= 40000 = [3 , 4 , 5 , 7 , 10 , 15 , 20 , 30 , 50 , 100 , 200 , 500 , 1000 ]= [0.01 , 0.05 , 0.10 ]= {a: [] for a in alphas}for n in ns:= rng.normal(size= (reps, n))= np.array([stats.shapiro(r).pvalue for r in x])for a in alphas:< a).mean())= plt.subplots()for a in alphas:= 1.96 * np.sqrt(a * (1 - a) / reps)- half, a + half, color= "gray" , alpha= 0.25 , lw= 0 )"o-" , label= f"α = { a} " )"log" )"標本の大きさ n" )str (n) for n in ns])"実際の棄却率" )= "upper left" , bbox_to_anchor= (0 , 0.84 ), ncols= 3 )
\(n=3\) は厳密、\(n\ge4\) でもどの有意水準でも棄却率はほぼ α に一致する。
検出力
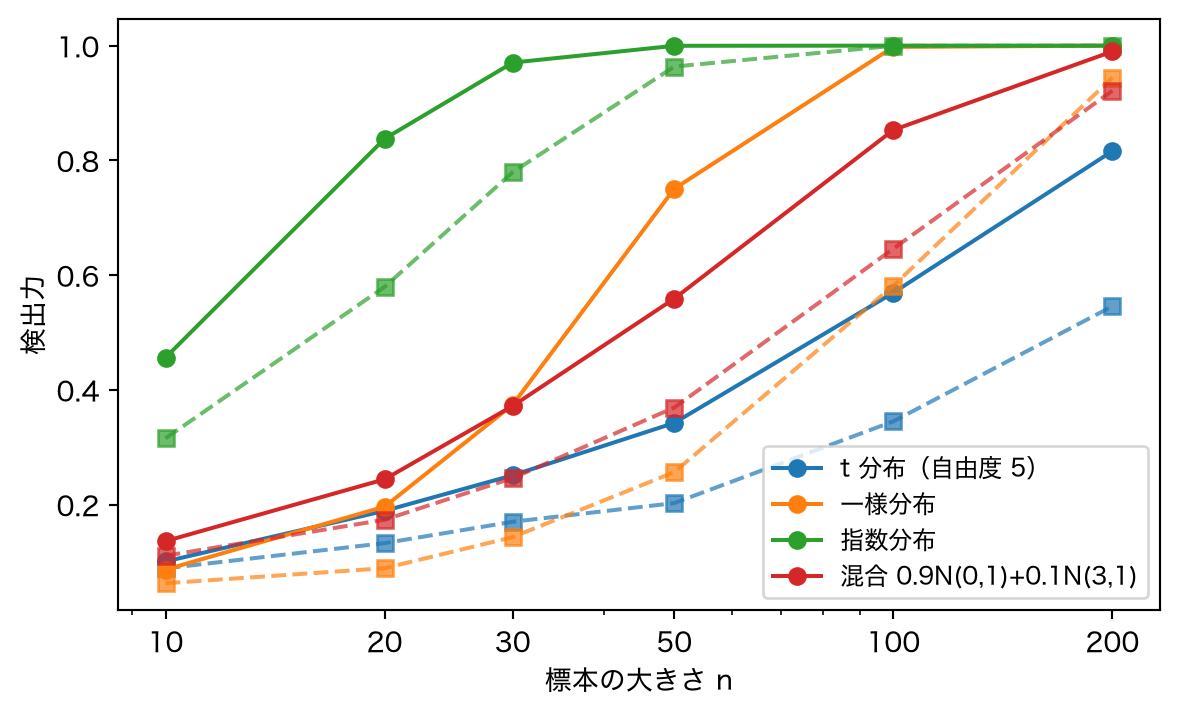
正規分布でない標本をどれだけ見抜けるかを、同じく平均・分散を指定しない Lilliefors 検定(推定した正規分布との Kolmogorov–Smirnov 距離)と比べる。
コード
from statsmodels.stats.diagnostic import lilliefors= {"t 分布(自由度 5)" : lambda size: rng.standard_t(5 , size= size),"一様分布" : lambda size: rng.uniform(size= size),"指数分布" : lambda size: rng.exponential(size= size),"混合 0.9N(0,1)+0.1N(3,1)" : lambda size: rng.normal(size= size) + 3 * (rng.uniform(size= size) < 0.1 ),= [10 , 20 , 30 , 50 , 100 , 200 ]= 4000 = plt.subplots()for name, gen in alts.items():= [], []for n in ns:= gen((reps, n))< 0.05 for r in x]))= "table" )[1 ] < 0.05 for r in x]))= ax.plot(ns, sw, "o-" , label= name)"s--" , color= line.get_color(), alpha= 0.7 )"log" )str (n) for n in ns])"標本の大きさ n" )"検出力" )= 9 )
どの対立仮説でも Shapiro–Wilk のほうが検出力が高い。裾の重さ(t 分布)や短さ(一様分布)のように、分布の中央ではなく両端に現れるずれは、Q-Q プロットの両端の傾きとして \(W\) に強く効く。 一方で、\(n=20\) では t 分布(自由度 5)や一様分布を 2 割程度しか見抜けない。有意でないことは、正規分布であることの証拠にはならない。
注意
大きな標本. \(n\) が数千になると、実用上問題にならない小さなずれでも p 値はほぼ 0 になる。t 検定のように中心極限定理で頑健な手法の前提を確かめるなら、p 値より Q-Q プロットの形を見るほうがよい。タイと丸め. 値が少数の種類に丸められていると、Q-Q プロットが階段状になり \(W\) が下がる。正規分布からのデータでも、測定単位が標準偏差に比べて粗いと棄却されやすい。検定を重ねる問題. 「正規性の検定で有意でなければ t 検定、有意なら順位検定 」のように結果で次の検定を選ぶと、全体の第一種の過誤率は名目の α と一致しない。残差に使う場合. 回帰の残差は独立でも同分布でもないので、帰無分布は厳密には成り立たない。目安として使う。
試してみる
同じ計算は noisymoon API の POST /v1/tests/shapiro から呼び出せる。\(W\) と p 値は R の shapiro.test、scipy の shapiro と一致する。
"https://api.noisymoon.jp/v1/tests/shapiro" , headers= {"X-API-Key" : KEY},= {"x" : list (x)}).json()
参考文献
Shapiro, S. S. and Wilk, M. B. (1965). An analysis of variance test for normality (complete samples). Biometrika , 52, 591–611.
Lloyd, E. H. (1952). Least-squares estimation of location and scale parameters using order statistics. Biometrika , 39, 88–95.
Blom, G. (1958). Statistical Estimates and Transformed Beta-Variables . Wiley.
Royston, P. (1992). Approximating the Shapiro–Wilk W-test for non-normality. Statistics and Computing , 2, 117–119.
Royston, P. (1995). Remark AS R94: A remark on algorithm AS 181: The W-test for normality. Applied Statistics , 44, 547–551.
Wichura, M. J. (1988). Algorithm AS 241: The percentage points of the normal distribution. Applied Statistics , 37, 477–484.
Lehmann, E. L. and Romano, J. P. (2022). Testing Statistical Hypotheses , 4th ed. Springer. 定理 5.1.2(Basu)。