\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の範囲
正規分布に従う標本の平均について、次の検定を扱う。
1 標本
\(\mu = \mu_0\) (両側)/ \(\mu \le \mu_0\) (片側)\(\mu \ne \mu_0\) / \(\mu > \mu_0\)
2 標本(等分散)
\(\mu_x - \mu_y = 0\) / \(\le 0\) \(\ne 0\) / \(> 0\)
対応あり
差 \(D_i = X_i - Y_i\) の 1 標本検定
逆向きの片側検定(\(\mu \ge \mu_0\) 対 \(\mu < \mu_0\) )は、\(X_i\) を \(-X_i\) に置き換えれば同じ議論になる。
このツールの使い方
必要なデータ
標本 \(x\)
数値の列(2〜100,000 点)
1 標本の検定ではこれだけ
標本 \(y\)
数値の列
2 標本では長さが違ってよい。対応ありでは \(x\) と同じ長さで、\(i\) 番目どうしが組
mu0数値(既定 0)
帰無仮説の値(1 標本は平均、2 標本・対応ありは差 \(x-y\) の平均)
alternativetwo-sided / greater / less両側・片側
equal_var真偽(既定 true)
2 標本のみ。false で Welch
confidence0〜1(既定 0.95)
信頼区間の水準
前提条件
正規分布 :各標本が正規分布から独立に得られていること(対応ありでは差 \(D_i\) が正規)。標本が大きければ中心極限定理により多少の非正規性には頑健だが、外れ値や強い歪みには弱い。独立性 :観測どうしが独立(時系列の自己相関があると p 値が小さく出すぎる)。等分散 (equal_var: true のとき):2 群の分散が等しいこと。疑わしければ false(Welch)。標本の分散が 0(すべて同じ値)だと計算できない。
出力する値
statistic, df, pvaluet 統計量、自由度(Welch は実数)、p 値
estimate, stderr平均(1 標本)または平均の差 \(\bar x-\bar y\) と、その標準誤差
confidence_intervallow, high(片側の対立仮説では一方が null = 無限大)と水準
x, y各標本の大きさ・平均・標準偏差
methodone-sample / Student / Welch / paired
何を示すか
主張は 「これらの t 検定は、分散が未知という局外母数があっても、不偏検定のなかで一様に最も検出力が高い(UMP 不偏)」 である。 証明は Lehmann and Romano, Testing Statistical Hypotheses , 4th ed. (2022) の 5.1〜5.3 節に沿い、そこで使う一般定理は主張を引用 する。 t 検定への当てはめ、\(\bar X\) と \(S^2\) の独立性、t 分布の密度、非心度は省略せずに示す。
分散が等しくない 2 標本(Welch の検定)は、この枠組みでは最適性を示せない。最後の節 で、近似としての導出だけを参考に載せる。
準備:引用する定理
指数型分布族と UMP 不偏検定
確率変数 \(X\) の分布が \[
\diff P_{\theta,\vartheta}(x) = C(\theta,\vartheta)\exp\Big(\theta\,U(x) + \sum_{i=1}^k \vartheta_i T_i(x)\Big)\diff\mu(x)
\tag{1}
\] の形(\(k+1\) 母数の指数型分布族)をしているとする。\(\theta\) が関心のある母数、\(\vartheta=(\vartheta_1,\dots,\vartheta_k)\) が局外母数である。 母数空間は凸で、次元が \(k+1\) 未満の線形空間に含まれず、\(\theta_0\) の両側に点をもつと仮定する。
のもとで、\(H_1:\theta\le\theta_0\) および \(H_4:\theta=\theta_0\) にはそれぞれ UMP 不偏検定が存在する。 それは \(T=t\) を与えたときの \(U\) の条件付き分布における検定で、 \(H_1\) では「\(U > C_0(t)\) で棄却」、\(H_4\) では「\(U < C_1(t)\) または \(U > C_2(t)\) で棄却」の形をもち、 定数は \(E_{\theta_0}[\phi\mid t]=\alpha\) (\(H_4\) ではさらに \(E_{\theta_0}[U\phi\mid t]=\alpha E_{\theta_0}[U\mid t]\) )で決まる。
のもとで、統計量 \(V=h(U,T)\) が \(\theta=\theta_0\) のとき \(T\) と独立であるとする。
\(h\) が各 \(t\) について \(u\) の増加関数なら、\(H_1\) の UMP 不偏検定は「\(V > C_0\) で棄却」、\(E_{\theta_0}\phi(V)=\alpha\) 。\(h(u,t)=a(t)u+b(t)\) (\(a(t)>0\) )なら、\(H_4\) の UMP 不偏検定は「\(V<C_1\) または \(V>C_2\) で棄却」、 \(E_{\theta_0}\phi(V)=\alpha\) 、\(E_{\theta_0}[V\phi(V)]=\alpha E_{\theta_0}V\) 。
定数 \(C\) は \(t\) によらない。
\(T\) が分布族 \(\mathcal P\) の十分統計量で、\(T\) の分布族が有界完備であるとする。 分布が \(\mathcal P\) の中で変わらない統計量 \(V\) (補助統計量)は \(T\) と独立である。 特に、(1) で \(\theta\) を固定した指数型分布族では、\(T\) は完備なので、分布が \(\vartheta\) によらない \(V\) は \(T\) と独立。
定理 B は、定理 A の「\(T\) を条件にした検定」を、\(T\) に依存しないひとつの統計量による条件なしの検定 に書き換えるための道具である。 t 検定の証明は、適切な \(U, T, V\) を見つけて定理 B の仮定を確かめる作業になる。
1 標本の t 検定
\(X_1,\dots,X_n \iid N(\xi,\sigma^2)\) 、\(\xi,\sigma\) はともに未知とする。\(X_i\) を \(X_i-\xi_0\) に置き換えれば、\(\xi_0=0\) としてよい。
指数型分布族としての表現
同時密度は \[
(2\pi\sigma^2)^{-n/2}\exp\Big(-\frac{n\xi^2}{2\sigma^2}\Big)\exp\Big(\frac{n\xi}{\sigma^2}\,\bar x - \frac{1}{2\sigma^2}\sum x_i^2\Big)
\] なので、 \[
\theta = \frac{n\xi}{\sigma^2},\quad \vartheta = -\frac{1}{2\sigma^2},\quad U=\bar X,\quad T=\sum X_i^2
\] とおくと (1) の形になる。\(\sigma^2>0\) だから \(\theta\le 0 \iff \xi\le 0\) 、\(\theta=0\iff\xi=0\) 。よって定理 A により、 \(H:\xi\le 0\) と \(H:\xi=0\) には UMP 不偏検定がある。あとは定理 B が使える \(V\) を見つければよい。
補題 1(\(\xi=0\) での独立性)
\(\xi = 0\) のとき、\(c\,(X_1,\dots,X_n)\) と \((X_1,\dots,X_n)\) で値が変わらない統計量 \(f\) (任意の \(c>0\) で \(f(cx)=f(x)\) )は、\(T=\sum X_i^2\) と独立である。
証明. \(\xi=0\) のとき \(X_i=\sigma Z_i\) 、\(Z_i\iid N(0,1)\) と書ける。\(f(X)=f(\sigma Z)=f(Z)\) なので、\(f(X)\) の分布は \(\sigma\) によらない(補助統計量)。 \(\xi=0\) に固定した族は \(\vartheta=-1/(2\sigma^2)\) だけをもつ 1 母数指数型分布族で、\(T=\sum X_i^2\) は十分かつ完備。定理 C より \(f(X)\) と \(T\) は独立。\(\square\)
定理 1(片側 t 検定は UMP 不偏)
\(H:\xi\le\xi_0\) 対 \(K:\xi>\xi_0\) の水準 \(\alpha\) の UMP 不偏検定は \[
t(X)=\frac{\sqrt n\,(\bar X-\xi_0)}{S},\qquad S^2=\frac{1}{n-1}\sum_{i=1}^n(X_i-\bar X)^2
\] が \(t_{n-1}\) 分布の上側 \(\alpha\) 点を超えたときに棄却する検定である。
証明. \(\xi_0=0\) とする。 \[
V=\frac{\bar X}{\sqrt{\sum (X_i-\bar X)^2}}=\frac{U}{\sqrt{T-nU^2}}
\] とおく。\(V\) は補題 1 の \(f\) の条件(尺度を変えても不変)を満たすので、\(\xi=0\) のとき \(T\) と独立。 また \(T\) を固定すると、\(u\mapsto u/\sqrt{t-nu^2}\) は \(|u|<\sqrt{t/n}\) で狭義増加である(導関数 \(t/(t-nu^2)^{3/2}>0\) )。 定理 B(前半)より、UMP 不偏検定は「\(V>C_0\) で棄却」の形で、\(C_0\) は \(\xi=0\) での \(V\) の分布だけで決まる。 \(t(X)=\sqrt{n(n-1)}\,V\) は \(V\) の狭義増加関数なので、棄却域は \(t(X)>C\) と同値。 \(\xi=0\) での \(t(X)\) の分布が \(t_{n-1}\) であることは定理 3 で示す。\(\square\)
定理 2(両側 t 検定は UMP 不偏)
\(H:\xi=\xi_0\) 対 \(K:\xi\ne\xi_0\) の水準 \(\alpha\) の UMP 不偏検定は、\(|t(X)|\) が \(t_{n-1}\) 分布の上側 \(\alpha/2\) 点を超えたときに棄却する検定である。
証明. \(\xi_0=0\) とする。定理 B(後半)は \(V\) が \(U\) の一次式 であることを要求するが、定理 1 の \(V\) はそうではない。そこで \[
W=\frac{\bar X}{\sqrt{\sum X_i^2}}=\frac{U}{\sqrt T}
\] を使う。\(T\) を固定すれば \(W=a(T)U\) 、\(a(T)=T^{-1/2}>0\) で一次式。尺度不変なので、補題 1 より \(\xi=0\) で \(T\) と独立。
\(\xi=0\) のとき \(X\mapsto -X\) で分布は変わらず、\(W(-X)=-W(X)\) だから \(W\) の分布は \(0\) について対称。 対称な分布では、棄却域 \(\{|W|\ge C\}\) 、\(P(|W|\ge C)=\alpha\) が定理 B の 2 条件を満たす。実際、 \(E[\phi(W)]=\alpha\) はそのまま成り立ち、\(\phi\) が偶関数で \(W\) が対称だから \(E[W\phi(W)]=0=\alpha E[W]\) 。
最後に \(t\) と \(W\) の関係を出す。\(\sum(X_i-\bar X)^2=T-n\bar X^2=T(1-nW^2)\) なので \[
t(X)=\frac{\sqrt n\,\bar X}{\sqrt{T(1-nW^2)/(n-1)}}=\frac{\sqrt{n(n-1)}\,W}{\sqrt{1-nW^2}} .
\] \(w\mapsto w/\sqrt{1-nw^2}\) は奇関数で狭義増加だから、\(|t|\) は \(|W|\) の狭義増加関数。よって \(\{|W|\ge C\}=\{|t|\ge C'\}\) 。\(\square\)
定理 3(\(\bar X\) と \(S^2\) の独立性と t 分布)
\(X_i\iid N(\xi,\sigma^2)\) のとき
\(\bar X\) と \(S^2\) は独立、\(\sqrt n(\bar X-\xi)/\sigma\sim N(0,1)\) 、\((n-1)S^2/\sigma^2\sim\chi^2_{n-1}\) 、\(t(X)=\sqrt n(\bar X-\xi_0)/S\) は、\(\xi=\xi_0\) のとき自由度 \(n-1\) の t 分布 \[
f_{\nu}(y)=\frac{\Gamma\big(\frac{\nu+1}{2}\big)}{\sqrt{\nu\pi}\,\Gamma\big(\frac{\nu}{2}\big)}\Big(1+\frac{y^2}{\nu}\Big)^{-\frac{\nu+1}{2}},\qquad \nu=n-1
\] に従う(Lehmann–Romano 式 (5.18))。
証明. 1. \(\sigma\) を固定した族 \(\{N(\xi,\sigma^2):\xi\in\R\}\) は \(\xi\) だけをもつ指数型分布族で、\(\bar X\) は十分かつ完備。 \(\sum(X_i-\bar X)^2\) は平行移動 \(x\mapsto x+c\mathbf 1\) で不変なので \(X_i=\xi+\sigma Z_i\) と書けば \(\sum(Z_i-\bar Z)^2\sigma^2\) に等しく、分布は \(\xi\) によらない。 定理 C より \(\bar X\) と \(S^2\) は独立(\(\sigma\) は任意なので、すべての \(\xi,\sigma\) で成り立つ)。
2. \(\bar X\sim N(\xi,\sigma^2/n)\) は正規分布の和の性質から明らか。 \(Z_i=(X_i-\xi)/\sigma\) とし、\(\sum Z_i^2=\sum(Z_i-\bar Z)^2+n\bar Z^2\) と分解する。 左辺は \(\chi^2_n\) 、右辺第 2 項は \(\chi^2_1\) で、1 より両項は独立。積率母関数を比べると、\(s<1/2\) で \[
(1-2s)^{-n/2}=M(s)\,(1-2s)^{-1/2}\quad\Longrightarrow\quad M(s)=(1-2s)^{-(n-1)/2},
\] ここで \(M\) は \(\sum(Z_i-\bar Z)^2=(n-1)S^2/\sigma^2\) の積率母関数。これは \(\chi^2_{n-1}\) の積率母関数なので、一意性より分布が決まる。
3. \(\xi=\xi_0\) のとき \(t=Z/\sqrt{Q/\nu}\) 、\(Z\sim N(0,1)\) 、\(Q\sim\chi^2_\nu\) 、\(Z\perp Q\) (1, 2 より)。 \(Q=q\) を与えたとき \(t\) は \(N(0,\nu/q)\) に従うので、 \[
f_t(y)=\int_0^\infty \sqrt{\frac{q}{2\pi\nu}}\,e^{-\frac{q y^2}{2\nu}}\cdot\frac{q^{\nu/2-1}e^{-q/2}}{2^{\nu/2}\Gamma(\nu/2)}\diff q
=\frac{1}{\sqrt{2\pi\nu}\,2^{\nu/2}\Gamma(\nu/2)}\int_0^\infty q^{\frac{\nu+1}{2}-1}e^{-\frac{q}{2}\left(1+\frac{y^2}{\nu}\right)}\diff q .
\] ガンマ積分 \(\int_0^\infty q^{a-1}e^{-bq}\diff q=\Gamma(a)b^{-a}\) (\(a=\frac{\nu+1}{2}\) 、\(b=\frac12(1+y^2/\nu)\) )を使うと \[
f_t(y)=\frac{\Gamma\big(\frac{\nu+1}{2}\big)\,2^{\frac{\nu+1}{2}}}{\sqrt{2\pi\nu}\,2^{\nu/2}\Gamma(\nu/2)}\Big(1+\frac{y^2}{\nu}\Big)^{-\frac{\nu+1}{2}}
=\frac{\Gamma\big(\frac{\nu+1}{2}\big)}{\sqrt{\nu\pi}\,\Gamma(\nu/2)}\Big(1+\frac{y^2}{\nu}\Big)^{-\frac{\nu+1}{2}} . \quad\square
\]
検出力と非心度
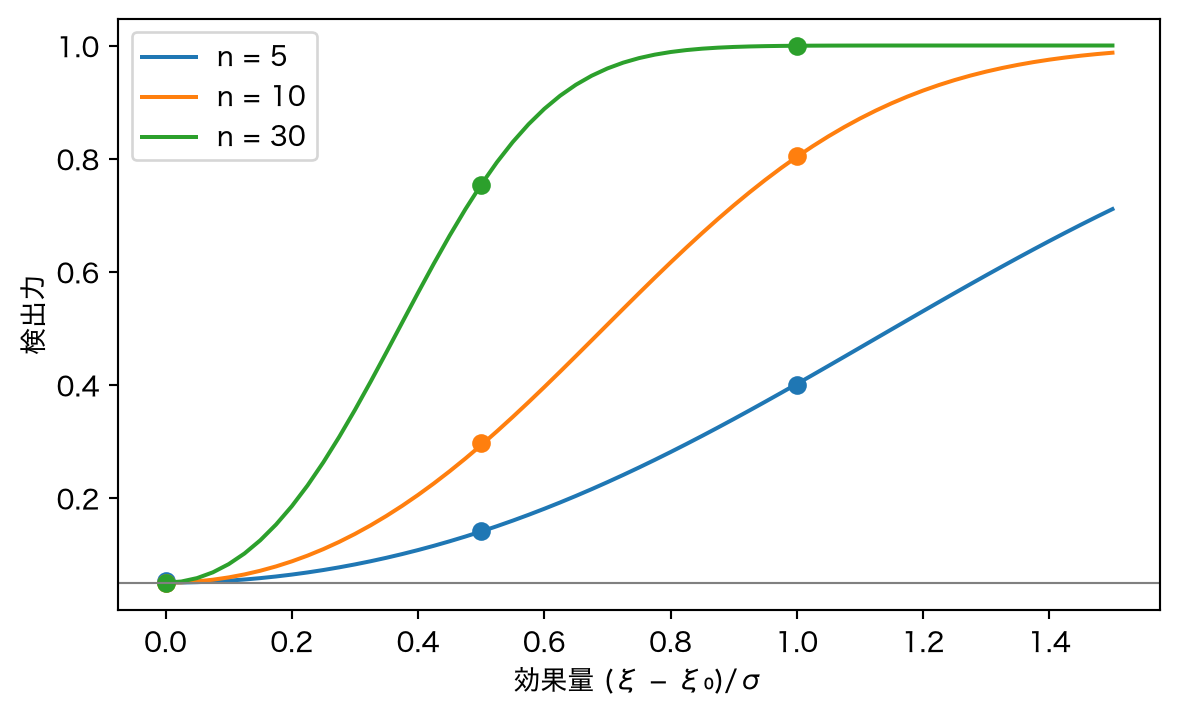
\(\xi\ne\xi_0\) のとき、\(t=(Z+\delta)/\sqrt{Q/\nu}\) 、\(\delta=\sqrt n(\xi-\xi_0)/\sigma\) と書ける(\(Z\perp Q\) は定理 3 の 1 から)。 これは非心度 \(\delta\) の非心 t 分布 で、検出力は \((\xi-\xi_0)/\sigma\) と \(n\) だけで決まる。 したがって、\(\xi\) を固定して \(\sigma\to\infty\) とすると \(\delta\to0\) となり、検出力は \(\alpha\) に近づく。 標本の大きさを固定した t 検定では、どれだけ \(\xi\) が離れていても、あらゆる \(\sigma\) に対して一定以上の検出力を保証することはできない (Lehmann–Romano 5.2 節)。
コード
import numpy as npimport matplotlib.pyplot as pltfrom scipy import stats"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(0 )= 0.05 = np.linspace(0 , 1.5 , 61 )= plt.subplots()for n in (5 , 10 , 30 ):= n - 1 = stats.t.ppf(1 - alpha / 2 , nu)= np.sqrt(n) * effects= stats.nct.sf(c, nu, delta) + stats.nct.cdf(- c, nu, delta)= ax.plot(effects, power, label= f"n = { n} " )for e in (0.0 , 0.5 , 1.0 ):= rng.normal(e, 1.0 , size= (10000 , n))= stats.ttest_1samp(x, 0.0 , axis= 1 ).pvalue< alpha).mean(), "o" , color= line.get_color())= "gray" , lw= 0.8 )"効果量 (ξ − ξ₀)/σ" )"検出力" )
効果量 0 の点が α = 0.05 の線に乗っていること(有意水準が守られている)と、シミュレーションが非心 t 分布の理論曲線に一致することが確かめられる。
2 標本の t 検定(等分散)
\(X_1,\dots,X_m\iid N(\xi,\sigma^2)\) 、\(Y_1,\dots,Y_n\iid N(\eta,\sigma^2)\) 、すべて独立で、分散は共通だが未知 とする。
指数型分布族としての表現
同時密度は \[
C(\xi,\eta,\sigma)\exp\Big(\frac{\xi}{\sigma^2}\sum x_i+\frac{\eta}{\sigma^2}\sum y_j-\frac{1}{2\sigma^2}\Big(\sum x_i^2+\sum y_j^2\Big)\Big).
\] 恒等式 \[
m\xi\bar x+n\eta\bar y=\frac{(\bar y-\bar x)(\eta-\xi)}{\frac1m+\frac1n}+\frac{(m\bar x+n\bar y)(m\xi+n\eta)}{m+n}
\] (右辺を展開して \(\bar x\xi\) 、\(\bar y\eta\) 、交差項の係数を比べれば確かめられる)により、 \[
\theta=\frac{\eta-\xi}{\big(\frac1m+\frac1n\big)\sigma^2},\quad \vartheta_1=\frac{m\xi+n\eta}{(m+n)\sigma^2},\quad \vartheta_2=-\frac{1}{2\sigma^2},
\] \[
U=\bar Y-\bar X,\quad T_1=m\bar X+n\bar Y,\quad T_2=\sum X_i^2+\sum Y_j^2
\] として (1) の形になる。\(\theta\le0\iff\eta-\xi\le0\) 。定理 A により UMP 不偏検定が存在する。
この記事と Lehmann–Romano は差を \(\eta-\xi=\mu_y-\mu_x\) で書いている。API と scipy は \(\mu_x-\mu_y\) を使うので、片側の向き(greater / less)は逆になる。
定理 4(2 標本 t 検定は UMP 不偏)
\[
t(X,Y)=\frac{\bar Y-\bar X}{s_p\sqrt{\frac1m+\frac1n}},\qquad s_p^2=\frac{\sum(X_i-\bar X)^2+\sum(Y_j-\bar Y)^2}{m+n-2}
\] について、\(H:\eta\le\xi\) の UMP 不偏検定は「\(t>C\) 」、\(H:\eta=\xi\) の UMP 不偏検定は「\(|t|>C'\) 」で棄却する。 \(\eta=\xi\) のとき \(t\sim t_{m+n-2}\) で、\(C, C'\) はその上側 \(\alpha\) 、\(\alpha/2\) 点。
証明. 独立性. \(\eta=\xi\) のとき、\((X_i-\xi)/\sigma\) 、\((Y_j-\xi)/\sigma\) は \(N(0,1)\) に従う。 \[
V=\frac{\bar Y-\bar X}{\sqrt{\sum(X_i-\bar X)^2+\sum(Y_j-\bar Y)^2}}
\] は共通の平行移動と尺度変換で不変なので、分布は \(\xi,\sigma\) によらない。\(\eta=\xi\) に固定した族では \((T_1,T_2)\) が十分かつ完備なので、定理 C より \(V\perp(T_1,T_2)\) 。
片側. \(\sum(X_i-\bar X)^2+\sum(Y_j-\bar Y)^2=T_2-\frac{T_1^2}{m+n}-\frac{mn}{m+n}U^2\) だから \(V=U/\sqrt{T_2-T_1^2/(m+n)-\frac{mn}{m+n}U^2}\) は、\(T\) を固定すると \(U\) の狭義増加関数。定理 B より「\(V>C_0\) 」が UMP 不偏で、\(t=\sqrt{(m+n-2)/(\frac1m+\frac1n)}\,V\) はその増加関数。
両側. \(W=U\big/\sqrt{T_2-T_1^2/(m+n)}\) は \(T\) を固定すると \(U\) の一次式で、\(V=W/\sqrt{1-\frac{mn}{m+n}W^2}\) の関係から \(V\) の関数、したがって \(T\) と独立。\(\eta=\xi\) で \((X,Y)\mapsto(-X,-Y)\) により \(W\) の分布は対称なので、定理 2 と同じ議論で「\(|W|\) が大きい」が UMP 不偏、それは「\(|t|\) が大きい」と同値。
分布. \(\bar X,\bar Y,\sum(X_i-\bar X)^2,\sum(Y_j-\bar Y)^2\) は定理 3 と独立性から互いに独立で、 \(\bar Y-\bar X\sim N\big(\eta-\xi,\ \sigma^2(\frac1m+\frac1n)\big)\) 、\((m+n-2)s_p^2/\sigma^2=\chi^2_{m-1}+\chi^2_{n-1}=\chi^2_{m+n-2}\) (独立な \(\chi^2\) の和)。 よって \[
t=\frac{Z+\delta}{\sqrt{Q/(m+n-2)}},\qquad \delta=\frac{\eta-\xi}{\sigma\sqrt{\frac1m+\frac1n}},
\] \(\eta=\xi\) なら \(\delta=0\) で定理 3 の 3 と同じ計算により \(t_{m+n-2}\) 。\(\square\)
対応のある 2 標本
同じ対象の前後の測定のように \((X_i,Y_i)\) が組になっているときは、\(D_i=X_i-Y_i\) が \(N(\mu_D,\sigma_D^2)\) に独立に従うと仮定し、\(D_1,\dots,D_n\) に1 標本の t 検定 を使う。 組の間の相関(\(\operatorname{Cov}(X_i,Y_i)\) )は \(\sigma_D^2=\sigma_X^2+\sigma_Y^2-2\operatorname{Cov}(X_i,Y_i)\) に吸収されるので、 正の相関があるほど分散が小さくなり、独立な 2 標本として扱うより検出力が高い。最適性は、\(D\) についての定理 1、2 がそのまま成り立つ。
試してみる
同じ計算は noisymoon API の POST /v1/tests/ttest-1samp、ttest-2samp、ttest-paired から呼び出せる。統計量・自由度・p 値・信頼区間は scipy の ttest_1samp / ttest_ind / ttest_rel と一致する。
"https://api.noisymoon.jp/v1/tests/ttest-2samp" , headers= {"X-API-Key" : KEY},= {"x" : list (x), "y" : list (y), "alternative" : "greater" }).json()
参考:分散が等しくない場合(Welch の検定)
\(X_i\sim N(\xi,\sigma^2)\) 、\(Y_j\sim N(\eta,\tau^2)\) で \(\sigma^2\ne\tau^2\) もありうる場合(Behrens–Fisher 問題 )は、局外母数が 3 つになり、 上の議論で使った「\(\eta=\xi\) のときに分布が局外母数によらない統計量」が見つからない。Lehmann–Romano も 5.3 節でこの問題を定理 A〜C の方法の対象外としている。 ここで示すのは近似 であって、UMP 不偏性のような最適性の主張ではない。
統計量. \(s_x^2, s_y^2\) をそれぞれの不偏分散として \[
t_W=\frac{\bar X-\bar Y}{\sqrt{s_x^2/m+s_y^2/n}} .
\] 分子は \(\xi=\eta\) で \(N\big(0,\ \sigma^2/m+\tau^2/n\big)\) 、分母の二乗 \(\hat v=s_x^2/m+s_y^2/n\) は分子と独立(定理 3 の 1 を各標本に使う)。 ただし \(\hat v\) は \(\chi^2\) の重み付き和 で、一般に \(\chi^2\) 分布の定数倍ではない。
Satterthwaite の近似. \(\hat v\) を \(v\,\chi^2_\nu/\nu\) (\(v=\sigma^2/m+\tau^2/n\) )で近似し、平均と分散を合わせて \(\nu\) を決める。 \(E\hat v=v\) は自動的に一致する。分散は、\(\operatorname{Var}(s_x^2)=2\sigma^4/(m-1)\) (\(\chi^2_{m-1}\) の分散 \(2(m-1)\) から)と独立性により \[
\operatorname{Var}\hat v=\frac{2\sigma^4}{m^2(m-1)}+\frac{2\tau^4}{n^2(n-1)},\qquad
\operatorname{Var}\Big(v\frac{\chi^2_\nu}{\nu}\Big)=\frac{2v^2}{\nu} .
\] 両者を等しいとおいて \[
\nu=\frac{\big(\sigma^2/m+\tau^2/n\big)^2}{\dfrac{(\sigma^2/m)^2}{m-1}+\dfrac{(\tau^2/n)^2}{n-1}} .
\] 未知の \(\sigma^2,\tau^2\) を \(s_x^2,s_y^2\) で置き換えたものが Welch の自由度で、\(t_W\) を自由度 \(\hat\nu\) (一般に整数でない)の t 分布で近似する。 API では equal_var: false で使える(既定は教科書どおり true)。
コード
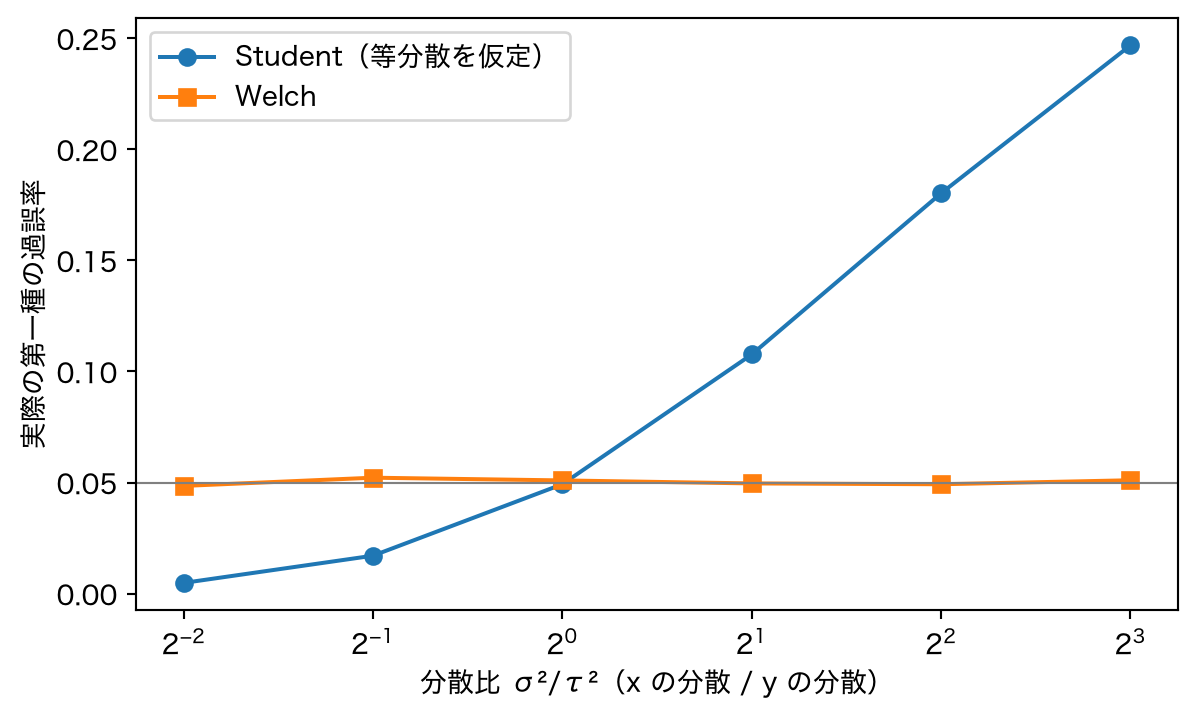
= 10 , 40 , 40000 = [0.25 , 0.5 , 1 , 2 , 4 , 8 ]= [], []for r in ratios:= rng.normal(0 , np.sqrt(r), size= (reps, m))= rng.normal(0 , 1 , size= (reps, n))= 1 ).pvalue < 0.05 ).mean())= 1 , equal_var= False ).pvalue < 0.05 ).mean())= plt.subplots()"o-" , label= "Student(等分散を仮定)" )"s-" , label= "Welch" )0.05 , color= "gray" , lw= 0.8 )"log" , base= 2 )"分散比 σ²/τ²(x の分散 / y の分散)" )"実際の第一種の過誤率" )
標本の小さい側(\(m=10\) )の分散が大きいと、等分散を仮定した Student の検定は有意水準を大きく超える(分散比 8 で約 25%)。逆に小さい側の分散が小さいと、過誤率が 5% を下回る保守的な検定になり、その分だけ検出力を失う。Welch の近似はどの分散比でもほぼ 5% を保つ。 分散が等しいと仮定できるなら Student の検定が最適(定理 4)だが、その仮定が疑わしいときの頑健さは Welch が上回る。
参考文献
Lehmann, E. L. and Romano, J. P. (2022). Testing Statistical Hypotheses , 4th ed. Springer. 定理 4.4.1(多母数指数型分布族の UMP 不偏検定)、定理 5.1.1、定理 5.1.2(Basu)、5.2 節(式 5.15–5.19)、5.3 節(式 5.27–5.30)。
Welch, B. L. (1947). The generalization of ‘Student’s’ problem when several different population variances are involved. Biometrika , 34, 28–35.
Satterthwaite, F. E. (1946). An approximate distribution of estimates of variance components. Biometrics Bulletin , 2, 110–114.