\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Corr}{\operatorname{Corr}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
この記事の範囲
値そのものではなく順位 だけを使う 3 つの検定を扱う。正規分布を仮定しないので、外れ値や歪んだ分布に強い。
Mann–Whitney の U 検定(Wilcoxon の順位和検定)
独立な 2 標本 \(x, y\)
\(x\) と \(y\) は同じ分布に従う2 標本の t 検定
Wilcoxon の符号付き順位検定
1 標本、または対応のある 2 標本の差 \(d=x-y\)
\(d\) の分布は 0 について対称1 標本・対応のある t 検定
Kruskal–Wallis 検定
独立な \(k\) 群
すべての群が同じ分布に従う
一元配置分散分析
このツールの使い方
必要なデータ
Mann–Whitney:x, y
数値の列(各 1〜100,000 点)
長さは違ってよい
Wilcoxon:x(と y)
数値の列
y を渡すと差 x − y を検定する(同じ長さ)
Kruskal–Wallis:groups
数値の列の列(2〜100 群)
labels で群の名前を付けられる
alternativetwo-sided / greater / lessMann–Whitney と Wilcoxon。greater は「\(x\) のほうが大きくなりやすい」
methodauto / exact / asymptotic正確な分布か正規近似か。auto は scipy と同じ基準で選ぶ(後述 )
use_continuity(Mann–Whitney) / correction(Wilcoxon)真偽(既定は true / false、scipy と同じ)
正規近似の連続修正
zero_method(Wilcoxon)wilcox / pratt / zsplit差が 0 の観測の扱い(後述 )
前提条件
独立性 :観測どうしが独立(Wilcoxon の対応ありでは組どうしが独立)。連続分布 が理想。同順位(タイ)があっても補正した近似で計算できるが、正確な分布はタイがない場合のもの。Mann–Whitney と Kruskal–Wallis の帰無仮説は「分布が同じ 」であり、「中央値が同じ」ではない。分散や形が違う群の比較では有意水準が守られない(後述 )。
Wilcoxon の帰無仮説は「0 について対称 」。歪んだ分布の中央値の検定には使えない(符号検定を使う)。
出力する値
statistic, pvalue, method統計量(Mann–Whitney は \(U_1\) 、Wilcoxon は両側で \(\min(R_+,R_-)\) ・片側で \(R_+\) 、Kruskal–Wallis は \(H\) )、p 値、使った方法
z正規近似の標準化統計量(asymptotic のとき)
prob_superiority, rank_biserialMann–Whitney:\(\hat P(X>Y)+\frac12\hat P(X=Y)=U_1/(mn)\) と、順位双列相関 \(2U_1/(mn)-1\)
r_plus, r_minus, rank_biserialWilcoxon:正・負の差の順位和と \((R_+-R_-)/(R_++R_-)\)
hodges_lehmann位置の推定値。Mann–Whitney は \(x_i-y_j\) の中央値、Wilcoxon は Walsh 平均 \((d_i+d_j)/2\) (\(i\le j\) )の中央値
df, epsilon_squared, groupsKruskal–Wallis:自由度 \(k-1\) 、効果量 \(H/(N-1)\) 、群ごとの大きさ・平均順位・中央値
何を示すか
帰無仮説のもとで順位の分布は元の分布によらない(分布によらない検定 になる理由)。
Mann–Whitney の \(U\) と順位和の関係、\(U\) の平均と分散(同順位の補正を含む)、正確な分布の漸化式。
Wilcoxon の \(R_+\) が独立なベルヌーイ変数の重み付き和になること、その平均・分散・正確な分布。
Kruskal–Wallis の \(H\) の 2 通りの表し方と、2 群では \(H\) が Mann–Whitney の \(z^2\) に一致すること。
漸近正規性(と \(H\) の漸近 \(\chi^2\) 分布)の証明は Lehmann (2006) を引用する。最後に、t 検定との検出力の比較と、分散が違うときに有意水準が崩れる例をシミュレーションで示す。
順位の帰無分布
\(Z_1,\dots,Z_N\) を連続分布から独立に得た標本とし、\(Z_i\) の順位を \(R_i\) (小さいほうから数えて何番目か)とする。連続分布なので同じ値が出る確率は 0 で、\((R_1,\dots,R_N)\) は \(\{1,\dots,N\}\) の並べ替えである。
補題 1. \((R_1,\dots,R_N)\) は \(N!\) 通りの並べ替えの上で一様に分布する。
証明. \(Z_1,\dots,Z_N\) は独立同分布なので、どの並べ替え \(\pi\) についても \((Z_{\pi(1)},\dots,Z_{\pi(N)})\) は \((Z_1,\dots,Z_N)\) と同じ分布に従う(交換可能性)。 ある並べ替え \(r\) について \(P(R=r)=P(Z_{r^{-1}(1)}<\dots<Z_{r^{-1}(N)})\) で、交換可能性からこれは \(r\) によらない。\(N!\) 通りの確率の和が 1 だから、どれも \(1/N!\) 。\(\square\)
系. 2 標本 \(X_1,\dots,X_m\iid F\) 、\(Y_1,\dots,Y_n\iid G\) を合わせて順位を付けると、\(F=G\) のもとで、\(X\) の順位の集合 \(\{R_1,\dots,R_m\}\) は \(\{1,\dots,N\}\) (\(N=m+n\) )の \(m\) 点部分集合の上で一様に分布する。 順位の関数である統計量の帰無分布は \(F\) によらず、\(m, n\) だけで決まる。
Mann–Whitney の U 検定
U と順位和
\[
U_1=\#\{(i,j): X_i>Y_j\}\ \big(+\tfrac12\#\{(i,j): X_i=Y_j\}\big),\qquad W=\sum_{i=1}^m R_i
\] とおく(\(W\) は Wilcoxon の順位和)。
定理 1. \(U_1=W-\dfrac{m(m+1)}{2}\) 。
証明. 同順位がないとき、\(X\) の順位を小さい順に \(R_{(1)}<\dots<R_{(m)}\) とする。\(i\) 番目に小さい \(X\) より小さい観測は \(R_{(i)}-1\) 個で、そのうち \(X\) は \(i-1\) 個だから、\(Y\) は \(R_{(i)}-i\) 個。これを \(i\) について足すと \(U_1=\sum_i(R_{(i)}-i)=W-m(m+1)/2\) 。同順位があるときは平均順位を使うと、同じ値の \(X\) と \(Y\) の組が \(\frac12\) ずつ数えられて同じ式が成り立つ。\(\square\)
\(U_2=mn-U_1\) は \(y\) を基準にした同じ量で、\(U_1/(mn)\) は \(\theta=P(X>Y)+\frac12P(X=Y)\) の不偏推定量である(prob_superiority)。帰無仮説 \(F=G\) のもとで \(\theta=\frac12\) 。
平均と分散
定理 2. \(F=G\) (連続)のもとで \(\E U_1=\dfrac{mn}{2}\) 、\(\Var U_1=\dfrac{mn(N+1)}{12}\) 。
証明. 補題 1 より各 \(R_i\) は \(\{1,\dots,N\}\) 上の一様分布に従い、\(\E R_i=\frac{N+1}2\) 、\(\Var R_i=\frac{N^2-1}{12}\) 。 \(\sum_{i=1}^NR_i=N(N+1)/2\) は定数なので \(0=\Var\sum_iR_i=N\Var R_1+N(N-1)\Cov(R_1,R_2)\) 、よって \(\Cov(R_i,R_j)=-\frac{N+1}{12}\) (\(i\ne j\) )。 \[
\Var W=m\frac{N^2-1}{12}-m(m-1)\frac{N+1}{12}=\frac{m(N+1)(N-m)}{12}=\frac{mn(N+1)}{12},
\] \(\E W=m(N+1)/2\) 。定理 1 から \(U_1\) の平均と分散が従う。\(\square\)
同順位の補正. 値が等しい観測に平均順位を付けると、順位は \(\{1,\dots,N\}\) ではなく平均順位の多重集合 \(a_1,\dots,a_N\) の並べ替えになる(補題 1 の議論は、同じ値の観測の入れ替えを区別しなければそのまま成り立つ)。 大きさ \(t\) の同順位の組 \(r,\dots,r+t-1\) を平均で置き換えると、偏差平方和は \(\sum_{s=0}^{t-1}(s-\frac{t-1}2)^2=\frac{t^3-t}{12}\) だけ減る。したがって \(\sum_k(a_k-\bar a)^2=\frac{N^3-N-\sum(t^3-t)}{12}\) 。\(W\) は母集団 \(a\) からの大きさ \(m\) の非復元抽出の和なので、有限母集団修正を使って \[
\Var U_1=\frac{mn}{N(N-1)}\sum_k(a_k-\bar a)^2=\frac{mn}{12}\Big((N+1)-\frac{\sum(t^3-t)}{N(N-1)}\Big).
\] API の正規近似はこの分散を使い、\(z=(U_1-mn/2\mp\frac12)/\sqrt{\Var U_1}\) (\(\mp\frac12\) は連続修正で、p 値が大きくなる向き)とする。
正確な分布
定理 3. \(F=G\) (連続)のもとで \(p_{m,n}(u)=P(U_1=u)\) は \[
p_{m,n}(u)=\frac{m}{N}\,p_{m-1,n}(u-n)+\frac{n}{N}\,p_{m,n-1}(u),\qquad p_{0,n}=p_{m,0}=\mathbb 1\{u=0\}
\] を満たす。
証明. \(N\) 個の観測のうち最大のものが \(X\) である確率は、交換可能性から \(m/N\) 。そのとき、その \(X\) はすべての \(Y\) より大きいので \(U_1\) に \(n\) を加え、残りの \(m-1\) 個の \(X\) と \(n\) 個の \(Y\) は(最大値が \(X\) であるという条件のもとでも)やはり独立同分布の標本として同じ問題になる。最大値が \(Y\) なら(確率 \(n/N\) )、その \(Y\) は \(U_1\) に何も加えず、残りは \(m\) 個と \(n-1\) 個の問題になる。\(\square\)
漸化式の項はすべて非負の確率の和なので、組み合わせの数(\(\binom{N}{m}\) は \(N=60\) 、\(m=30\) で \(10^{17}\) を超える)を経由せずに、裾の小さな確率まで桁落ちなく計算できる。API の exact はこれを使い、p 値は \(P(U\ge U_1)\) (片側)、\(2P(U\ge\max(U_1,U_2))\) (両側)とする。
何を検定しているか
\(U_1/(mn)\to\theta\) なので、この検定は \(\theta=P(X>Y)+\frac12P(X=Y)\) が \(\frac12\) から離れた対立仮説に対して一致性をもつ(Lehmann 2006, 2 章)。 中央値の差の検定ではない。 位置だけがずれた分布(\(G(x)=F(x+\Delta)\) )を仮定すれば \(\theta\ne\frac12\iff\Delta\ne0\) となり、中央値の比較として読める。そのときの \(\Delta\) の推定値が Hodges–Lehmann 推定量 \(\hat\Delta=\operatorname{median}_{i,j}(X_i-Y_j)\) (hodges_lehmann)で、\(U_1(\Delta)\) (\(X_i-\Delta\) で計算した \(U_1\) )がほぼ \(mn/2\) となる \(\Delta\) である(差 \(X_i-Y_j\) のうち \(\Delta\) より大きいものと小さいものが半分ずつになる)。
Wilcoxon の符号付き順位検定
差 \(D_1,\dots,D_n\) が独立に、0 について対称な連続分布に従うとする(帰無仮説)。\(|D_i|\) に順位 \(1,\dots,n\) を付け、正の \(D_i\) の順位の和を \(R_+\) 、負の和を \(R_-\) とする(\(R_++R_-=n(n+1)/2\) )。
補題 2. 帰無仮説のもとで、符号 \(\operatorname{sign}D_i\) と絶対値 \(|D_i|\) は独立で、符号は \(\pm1\) を確率 \(\frac12\) ずつとる。
証明. 対称性から \(D_i\) と \(-D_i\) は同じ分布に従う。任意の集合 \(A\subset(0,\infty)\) について \(P(D_i>0,|D_i|\in A)=P(D_i\in A)=P(-D_i\in A)=P(D_i<0,|D_i|\in A)\) で、2 つの和は \(P(|D_i|\in A)\) (\(P(D_i=0)=0\) )。よって \(P(D_i>0,|D_i|\in A)=\frac12P(|D_i|\in A)\) 。\(\square\)
定理 4. 帰無仮説のもとで \(R_+\overset d=\sum_{k=1}^n kB_k\) 、\(B_k\iid\text{Bernoulli}(\frac12)\) 。したがって \[
\E R_+=\frac{n(n+1)}{4},\qquad \Var R_+=\frac{n(n+1)(2n+1)}{24},
\] 正確な分布 \(q_n(w)=P(R_+=w)\) は \(q_n(w)=\frac12q_{n-1}(w)+\frac12q_{n-1}(w-n)\) を満たす。
証明. 補題 2 と独立性から、\(|D|\) の順位の並びを条件とすると、順位 \(k\) の観測の符号は他と独立に確率 \(\frac12\) で正になる。\(B_k=\mathbb 1\{\text{順位 }k\text{ の差が正}\}\) とすれば \(R_+=\sum_kkB_k\) で、条件付き分布が条件によらないので無条件でも同じ。 \(\E R_+=\frac12\sum k\) 、\(\Var R_+=\frac14\sum k^2\) 。漸化式は \(B_n\) で場合分けした式である。\(\square\)
同順位があるときは順位 \(k\) を平均順位 \(a_k\) に置き換え、\(\Var R_+=\frac14\sum a_k^2=\frac{1}{24}\big(n(n+1)(2n+1)-\frac12\sum(t^3-t)\big)\) (Mann–Whitney と同じく、平均で置き換えると 2 乗和が \(\frac{t^3-t}{12}\) 減る)。
差が 0 の観測
連続分布では起きないが、丸めたデータでは \(D_i=0\) が現れる。zero_method で扱いを選ぶ(scipy と同じ)。
wilcox(既定)0 を捨て、残りの \(n'\) 個で検定する
pratt0 も含めて \(|D|\) に順位を付け、0 の順位は \(R_+\) にも \(R_-\) にも入れない。平均と分散から 0 の分(\(n_0(n_0+1)/4\) など)を引く(Cureton 1967)
zsplit0 の順位を半分ずつ \(R_+\) と \(R_-\) に入れる
Pratt の扱いは、0 を捨てると他の観測の順位が変わってしまう(0 は最も小さい絶対値なので、捨てると残りの順位が 0 の個数だけ詰まる)という不自然さを避ける。
何を検定しているか
帰無仮説は「0 について対称」であり、対称性を仮定しなければ中央値の検定にはならない。対称性を仮定すれば中心 \(\mu\) についての検定で、\(\mu\) の Hodges–Lehmann 推定量は Walsh 平均 \((D_i+D_j)/2\) (\(i\le j\) )の中央値(擬似中央値)である。歪んだ分布の中央値そのものを調べたいときは、符号だけを使う符号検定が適切である。
Kruskal–Wallis 検定
\(k\) 群の大きさを \(n_1,\dots,n_k\) (\(N=\sum n_j\) )、全体で付けた順位の群ごとの和を \(R_j\) 、平均を \(\bar R_j=R_j/n_j\) とする。 \[
H=\frac{12}{N(N+1)}\sum_{j=1}^kn_j\Big(\bar R_j-\frac{N+1}2\Big)^2=\frac{12}{N(N+1)}\sum_{j=1}^k\frac{R_j^2}{n_j}-3(N+1).
\] 順位に対する一元配置分散分析の群間平方和を、順位の分散 \((N^2-1)/12\) で基準化したもの(に \((N-1)/N\) を掛けたもの)である。2 つ目の形は、2 乗を展開して \(\sum_jR_j=N(N+1)/2\) を使えば得られる。 同順位があるときは \(H\) を \(1-\sum(t^3-t)/(N^3-N)\) で割る。帰無仮説のもとで、各 \(n_j\to\infty\) のとき \(H\) は自由度 \(k-1\) の \(\chi^2\) 分布に収束する(Lehmann 2006, 5 章)。API はこの近似で p 値を計算する(scipy と同じ)。
定理 5. \(k=2\) のとき、\(H\) は連続修正なしの Mann–Whitney の正規近似の \(z^2\) に一致する(同順位の補正を含めて)。
証明. \(c=\frac{N+1}2\) とおく。\(n_1(\bar R_1-c)+n_2(\bar R_2-c)=\sum_jR_j-Nc=0\) だから \(\bar R_2-c=-\frac{n_1}{n_2}(\bar R_1-c)\) で、 \[
H=\frac{12}{N(N+1)}\,n_1(\bar R_1-c)^2\Big(1+\frac{n_1}{n_2}\Big)=\frac{12\,n_1}{n_2(N+1)}(\bar R_1-c)^2 .
\] 一方、定理 1、2 から \(U_1-\frac{mn}2=W-\frac{m(N+1)}2=n_1(\bar R_1-c)\) (\(m=n_1\) 、\(n=n_2\) )で \[
z^2=\frac{n_1^2(\bar R_1-c)^2}{n_1n_2(N+1)/12}=\frac{12\,n_1}{n_2(N+1)}(\bar R_1-c)^2=H .
\] 同順位の補正は、\(H\) の割る因子と、\(\Var U_1\) に掛かる因子 \(1-\sum(t^3-t)/(N^3-N)\) が同じなので、補正後も一致する。\(\square\)
方法の選び方
method: "auto" は scipy と同じ基準で選ぶ。
Mann–Whitney
どちらかの標本が 8 以下で、同順位がない
それ以外
Wilcoxon
\(n\le50\) で、同順位も 0 もない\(n>50\) 、または同順位・0 があって \(n>13\)
Wilcoxon で \(n\le13\) かつ同順位か 0 があるときは、\(2^n\) 通りの符号の付け方をすべて数える並べ替え検定 にする(結果の method は permutation)。補題 2 の議論は同順位があっても符号について成り立つので、これは平均順位のもとでの正確な p 値である。 正確な分布は Mann–Whitney で \(mn\le20{,}000\) 、Wilcoxon で \(n\le500\) まで指定できる。
API の結果は、統計量・p 値・\(z\) が scipy の mannwhitneyu / wilcoxon / kruskal と 5914 項目(上のすべての方法、対立仮説、連続修正の有無、zero_method、同順位と 0、平均が大きく分散が小さいデータ)で、相対誤差 \(10^{-9}\) 以内で一致することを確かめている。
t 検定との比較
検出力
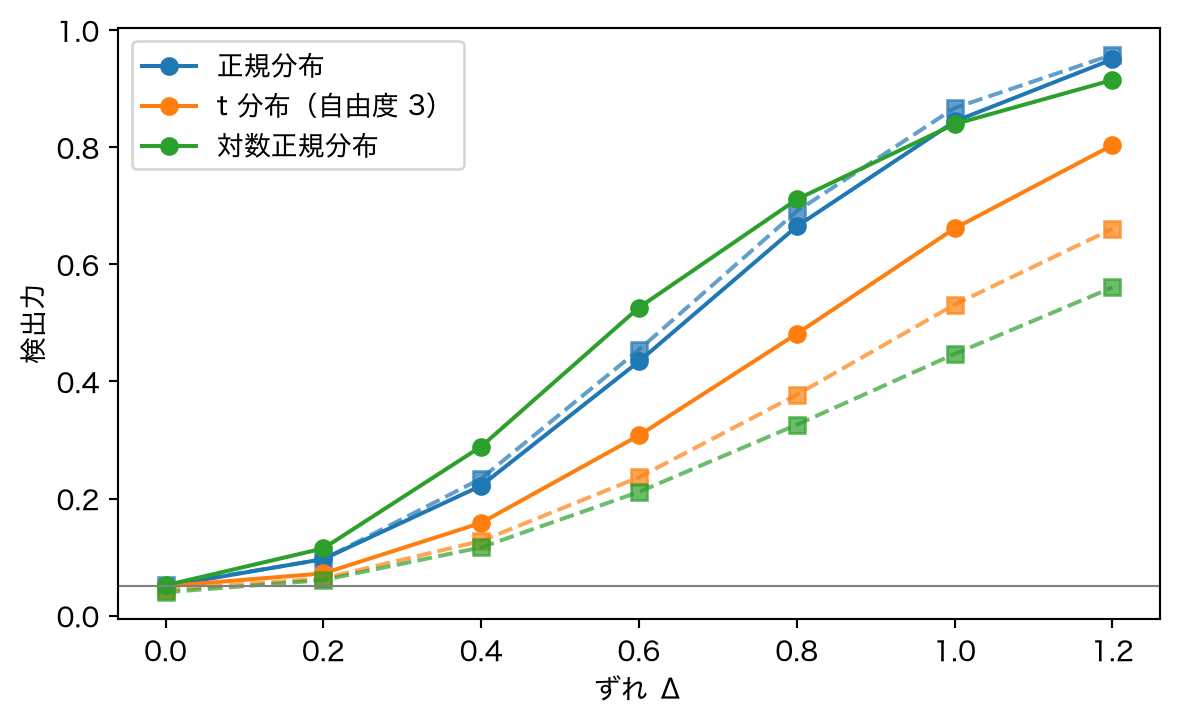
正規分布のもとでは t 検定が最適(t 検定の記事 )だが、順位の検定が失う検出力はわずかである。 位置だけがずれた分布での漸近相対効率(同じ検出力を得るのに必要な標本の大きさの比の逆数)は、正規分布で \(3/\pi\approx0.955\) 、どんな分布でも \(0.864\) 以上で、裾の重い分布では 1 を大きく超えうる(Hodges and Lehmann 1956)。
コード
import numpy as npimport matplotlib.pyplot as pltfrom scipy import stats"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(0 )= 20 , 10000 = np.linspace(0 , 1.2 , 7 )= {"正規分布" : lambda s: rng.normal(size= s),"t 分布(自由度 3)" : lambda s: rng.standard_t(3 , size= s),"対数正規分布" : lambda s: rng.lognormal(0 , 1 , size= s),= plt.subplots()for name, gen in dists.items():= [], []for d in deltas:= gen((reps, n)) + d, gen((reps, n))= 1 , method= "asymptotic" ).pvalue < 0.05 ).mean())= 1 ).pvalue < 0.05 ).mean())= ax.plot(deltas, mw, "o-" , label= name)"s--" , color= line.get_color(), alpha= 0.7 )0.05 , color= "gray" , lw= 0.8 )"ずれ Δ" )"検出力" )
正規分布では t 検定がわずかに上回る程度だが、裾の重い t 分布や歪んだ対数正規分布では Mann–Whitney が大きく上回る(\(\Delta=0.8\) の対数正規分布で約 0.71 対 0.33)。外れ値はどれほど極端でも順位としては最大値にしかならないのに対し、t 検定の標準偏差は外れ値で大きく膨らむからである。
分散が違うとき
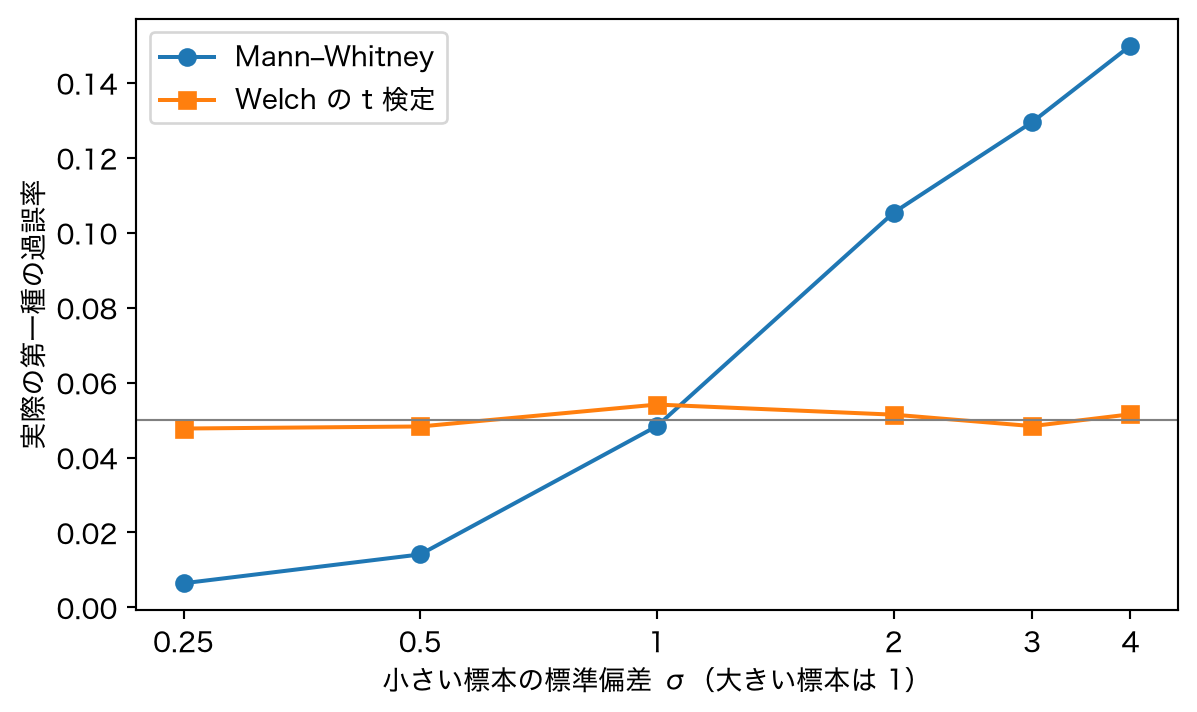
Mann–Whitney の帰無仮説は \(F=G\) であって、中央値や \(\theta=\frac12\) だけではない。中心が同じでも分散が違うと、\(U_1\) の分散は定理 2 の値と違い、有意水準が守られない。
コード
= 10 , 40 , 20000 = [0.25 , 0.5 , 1 , 2 , 3 , 4 ]= [], []for s in sigmas:= rng.normal(0 , s, (reps, m)), rng.normal(0 , 1 , (reps, n2))= 1 , method= "asymptotic" ).pvalue < 0.05 ).mean())= 1 , equal_var= False ).pvalue < 0.05 ).mean())= plt.subplots()"o-" , label= "Mann–Whitney" )"s-" , label= "Welch の t 検定" )0.05 , color= "gray" , lw= 0.8 )"log" , base= 2 )str (s) for s in sigmas])"小さい標本の標準偏差 σ(大きい標本は 1)" )"実際の第一種の過誤率" )
小さい標本の分散が大きいと過誤率は 5% を大きく超え(\(\sigma=3\) で約 13%)、逆だと極端に保守的になる。t 検定の等分散の仮定と同じ構造の問題で、順位にしても解消しない。 「中央値の差」を調べたいのに分散も違う場合は、Welch の t 検定、Brunner–Munzel 検定、あるいは Hodges–Lehmann 推定量のブートストラップ信頼区間を検討する。
試してみる
同じ計算は noisymoon API の POST /v1/tests/mannwhitney、wilcoxon、kruskal から呼び出せる。統計量と p 値は scipy の mannwhitneyu / wilcoxon / kruskal と一致する。
"https://api.noisymoon.jp/v1/tests/mannwhitney" , headers= {"X-API-Key" : KEY},= {"x" : list (x), "y" : list (y), "alternative" : "greater" }).json()"https://api.noisymoon.jp/v1/tests/kruskal" , headers= {"X-API-Key" : KEY},= {"groups" : [list (a), list (b), list (c)], "labels" : ["A" , "B" , "C" ]}).json()
参考文献
Lehmann, E. L. (2006). Nonparametrics: Statistical Methods Based on Ranks , revised ed. Springer. 1〜5 章。
Mann, H. B. and Whitney, D. R. (1947). On a test of whether one of two random variables is stochastically larger than the other. Annals of Mathematical Statistics , 18, 50–60.
Wilcoxon, F. (1945). Individual comparisons by ranking methods. Biometrics Bulletin , 1, 80–83.
Kruskal, W. H. and Wallis, W. A. (1952). Use of ranks in one-criterion variance analysis. Journal of the American Statistical Association , 47, 583–621.
Hodges, J. L. and Lehmann, E. L. (1956). The efficiency of some nonparametric competitors of the t-test. Annals of Mathematical Statistics , 27, 324–335.
Pratt, J. W. (1959). Remarks on zeros and ties in the Wilcoxon signed rank procedures. Journal of the American Statistical Association , 54, 655–667.
Cureton, E. E. (1967). The normal approximation to the signed-rank sampling distribution when zero differences are present. Journal of the American Statistical Association , 62, 1068–1069.
Fagerland, M. W. and Sandvik, L. (2009). The Wilcoxon–Mann–Whitney test under scrutiny. Statistics in Medicine , 28, 1487–1497.