\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
このツールの使い方 POST /v1/sem/fit
必要なデータ モデル model(lavaan の構文)と、データ行列 X(行が観測、列が変数、欠測は null)と列名 names。データの代わりに共分散行列 cov と標本の大きさ n(平均構造を使うなら平均 mean)でもよい
前提条件 観測変数が多変量正規分布 に従い、観測が独立(最尤法。正規性が崩れると χ² と標準誤差が偏る)。モデルが識別 されていること(因子ごとに尺度を決める、母数の数 ≤ 積率の数)。欠測はリストワイズ除去(完全にランダムな欠測でないと偏る)。標本はおおむね 200 以上が目安
出力する値 母数ごとの推定値・標準誤差・z・p 値・95% 信頼区間・標準化解(std.all)、従属変数の R²、χ² 検定(df・p 値)、CFI・TLI・RMSEA(90% 信頼区間と close fit の p 値)・SRMR、対数尤度・AIC・BIC、モデルの共分散行列と残差
推定値・標準誤差・適合度は R の lavaan(0.7.2、fixed.x = FALSE)と 11 のモデル(確認的因子分析、等値制約、共分散行列の入力、MIMIC、PoliticalDemocracy、媒介モデル、潜在成長曲線など)で突き合わせている。
モデル:パス図は共分散行列を決める
観測変数 \(x\) (\(p\) 個)の共分散行列を、少数の母数 \(\theta\) で表す: \[
\Sigma(\theta)\approx S .
\] たとえば 1 因子モデル \(x_j=\lambda_jf+\varepsilon_j\) (\(\Var f=\phi\) 、\(\Var\varepsilon_j=\psi_j\) 、すべて無相関)なら \(\Sigma=\phi\lambda\lambda^\top+\operatorname{diag}(\psi)\) である。パス図の矢印(→ が回帰・負荷量、↔︎ が共分散)がそのまま \(\Sigma(\theta)\) の形を決める。
RAM 表記
観測変数と潜在変数をまとめた \(m\) 個の変数 \(v\) について、 \[
v=Av+u,\qquad \Var u=S,\qquad E\,u=M
\] と書く(McArdle & McDonald, 1984)。\(A_{ij}\) は \(v_j\to v_i\) の係数(負荷量と回帰係数)、\(S\) は分散・共分散、\(M\) は切片である。\(B=(I-A)^{-1}\) とおくと \(v=Bu\) なので、観測変数を取り出す行列 \(F=[I_p\ 0]\) を使って \[
\Sigma(\theta)=F\,B\,S\,B^\top F^\top,\qquad \mu(\theta)=F\,B\,M .
\] 測定モデル・構造モデル・平均構造がこの 1 本の式に入るので、実装は \(A,S,M\) に母数を置くだけでよい。
lavaan の構文
f =~ x1 + x2 + x3因子 f の指標(負荷量)
\(A_{x_j,f}\)
y ~ x + z回帰
\(A_{y,x}\) , \(A_{y,z}\)
x1 ~~ x2、f ~~ f共分散・分散
\(S\)
y ~ 1切片・平均
\(M\)
0.5*x2、NA*x1、a*x2、start(1)*x2固定、自由、ラベル(同じラベルは等値制約)、初期値
書かなかった母数は lavaan の sem()・cfa() と同じ規則で補う:各因子の最初の指標の負荷量を 1 に固定 (尺度の決定)、すべての変数の分散、外生の潜在変数どうし・外生の観測変数どうし・最終的な従属変数どうしの共分散を自由母数にする。 因子の分散を 1 に固定したいときは f =~ NA*x1 + x2 + x3 と f ~~ 1*f を書く。
識別
\(\Sigma(\theta_1)=\Sigma(\theta_2)\) なら \(\theta_1=\theta_2\) 、であることを識別 という。必要条件は \[
k\le \frac{p(p+1)}{2}\ (+p\text{:平均構造})
\] (\(k\) は自由母数の数。t 規則)。十分ではないので、推定後に情報行列が特異になったら識別されていないと警告する。 自由度 \(\mathrm{df}=p(p+1)/2\,(+p)-k\) が 0 のモデルは飽和 していて、データに完全に一致するので適合度は評価できない。
最尤推定
\(x_1,\dots,x_N\) が独立に \(N_p(\mu,\Sigma)\) に従うとき、\(S=\frac1N\sum(x_i-\bar x)(x_i-\bar x)^\top\) (\(N\) で割る)とすると、対数尤度は \[
\ell(\theta)=-\frac N2\Big[p\log 2\pi+\log|\Sigma|+\operatorname{tr}(S\Sigma^{-1})+(\bar x-\mu)^\top\Sigma^{-1}(\bar x-\mu)\Big].
\] 制約のないモデル(飽和モデル、\(\hat\Sigma=S,\hat\mu=\bar x\) )の対数尤度は \(\ell_1=-\frac N2[p\log2\pi+\log|S|+p]\) なので、 \[
F_{\mathrm{ML}}(\theta)=\log|\Sigma|+\operatorname{tr}(S\Sigma^{-1})-\log|S|-p+(\bar x-\mu)^\top\Sigma^{-1}(\bar x-\mu)=\frac{2}{N}\big(\ell_1-\ell(\theta)\big)
\] を最小にすることが最尤推定である。\(F_{\mathrm{ML}}\ge0\) で、\(\Sigma=S,\mu=\bar x\) のときだけ 0 になる(\(\log|\Sigma S^{-1}|\) の固有値ごとの不等式 \(\lambda-1-\log\lambda\ge0\) による)。
共分散行列だけを渡した場合は、それを \(N-1\) で割った不偏分散とみなし、\((N-1)/N\) 倍してから使う(lavaan の既定と同じ。rescale_cov: false で無効)。
勾配
\(\Sigma_{\text{full}}=BSB^\top\) 、\(\mu_{\text{full}}=BM\) について、 \[
\frac{\partial\Sigma_{\text{full}}}{\partial A_{ij}}=Be_ie_j^\top\Sigma_{\text{full}}+\Sigma_{\text{full}}e_je_i^\top B^\top,\quad
\frac{\partial\Sigma_{\text{full}}}{\partial S_{ij}}=B(E_{ij}+E_{ji})B^\top\ (i\ne j),\quad
\frac{\partial\mu_{\text{full}}}{\partial A_{ij}}=Be_i(BM)_j,\quad
\frac{\partial\mu_{\text{full}}}{\partial M_i}=Be_i .
\]
証明. \(B(I-A)=I\) を微分して \(dB\,(I-A)-B\,dA=0\) 、つまり \(dB=B\,dA\,B\) 。 \(d(BSB^\top)=dB\,SB^\top+BS\,dB^\top=B\,dA\,\Sigma_{\text{full}}+\Sigma_{\text{full}}\,dA^\top B^\top\) に \(dA=E_{ij}=e_ie_j^\top\) を入れる。\(\mu\) も同様に \(d(BM)=B\,dA\,BM\) 。\(S,M\) については線形。\(\square\)
観測変数の部分を取り出したものを \(\Sigma_k=\partial\Sigma/\partial\theta_k\) 、\(\mu_k\) と書く。同じラベルの母数(等値制約)は、それぞれの位置の微分を足す。
\(d=\bar x-\mu\) 、\(W=\Sigma^{-1}-\Sigma^{-1}(S+dd^\top)\Sigma^{-1}\) とすると \[
\frac{\partial F_{\mathrm{ML}}}{\partial\theta_k}=\operatorname{tr}(W\Sigma_k)-2\,d^\top\Sigma^{-1}\mu_k .
\]
証明. \(d\log|\Sigma|=\operatorname{tr}(\Sigma^{-1}d\Sigma)\) 、\(d\Sigma^{-1}=-\Sigma^{-1}d\Sigma\,\Sigma^{-1}\) から \(d\operatorname{tr}(S\Sigma^{-1})=-\operatorname{tr}(\Sigma^{-1}S\Sigma^{-1}d\Sigma)\) 、 \(d(d^\top\Sigma^{-1}d)=-2d^\top\Sigma^{-1}d\mu-\operatorname{tr}(\Sigma^{-1}dd^\top\Sigma^{-1}d\Sigma)\) 。まとめると上の式。\(\square\)
フィッシャースコアリングと標準誤差
\(F_{\mathrm{ML}}\) の 2 階微分の期待値(真の値のまわりで \(S\approx\Sigma\) 、\(d\approx0\) とおいたもの)は \[
\mathcal I_{kl}=\tfrac12\operatorname{tr}(\Sigma^{-1}\Sigma_k\Sigma^{-1}\Sigma_l)+\mu_k^\top\Sigma^{-1}\mu_l,\qquad
E\Big[\frac{\partial^2F_{\mathrm{ML}}}{\partial\theta_k\partial\theta_l}\Big]=2\mathcal I_{kl}
\] で、\(N\mathcal I\) が 1 観測あたりではなく標本全体の Fisher 情報行列になる(\(\ell=\ell_1-\tfrac N2F_{\mathrm{ML}}\) より)。 更新 \(\theta\leftarrow\theta-t\,(2\mathcal I)^{-1}\nabla F_{\mathrm{ML}}\) を、\(F_{\mathrm{ML}}\) が十分に減る(Armijo 条件)まで \(t\) を半分にしながら繰り返す。 収束後の標準誤差 は \((N\mathcal I(\hat\theta))^{-1}\) の対角の平方根(lavaan の既定 information = "expected" と同じ)。
最小値の精度について:lavaan(nlminb)の既定の停止条件は、F がほとんど変わらない方向(残差共分散など)に \(10^{-4}\) 程度の誤差を残すことがある。比較テストでは、こちらの \(F_{\mathrm{ML}}\) の最小値が lavaan 以下であることを確かめたうえで、こちらの推定値を lavaan に渡して標準誤差と適合度を同じ点で比べている。
適合度
χ² 検定
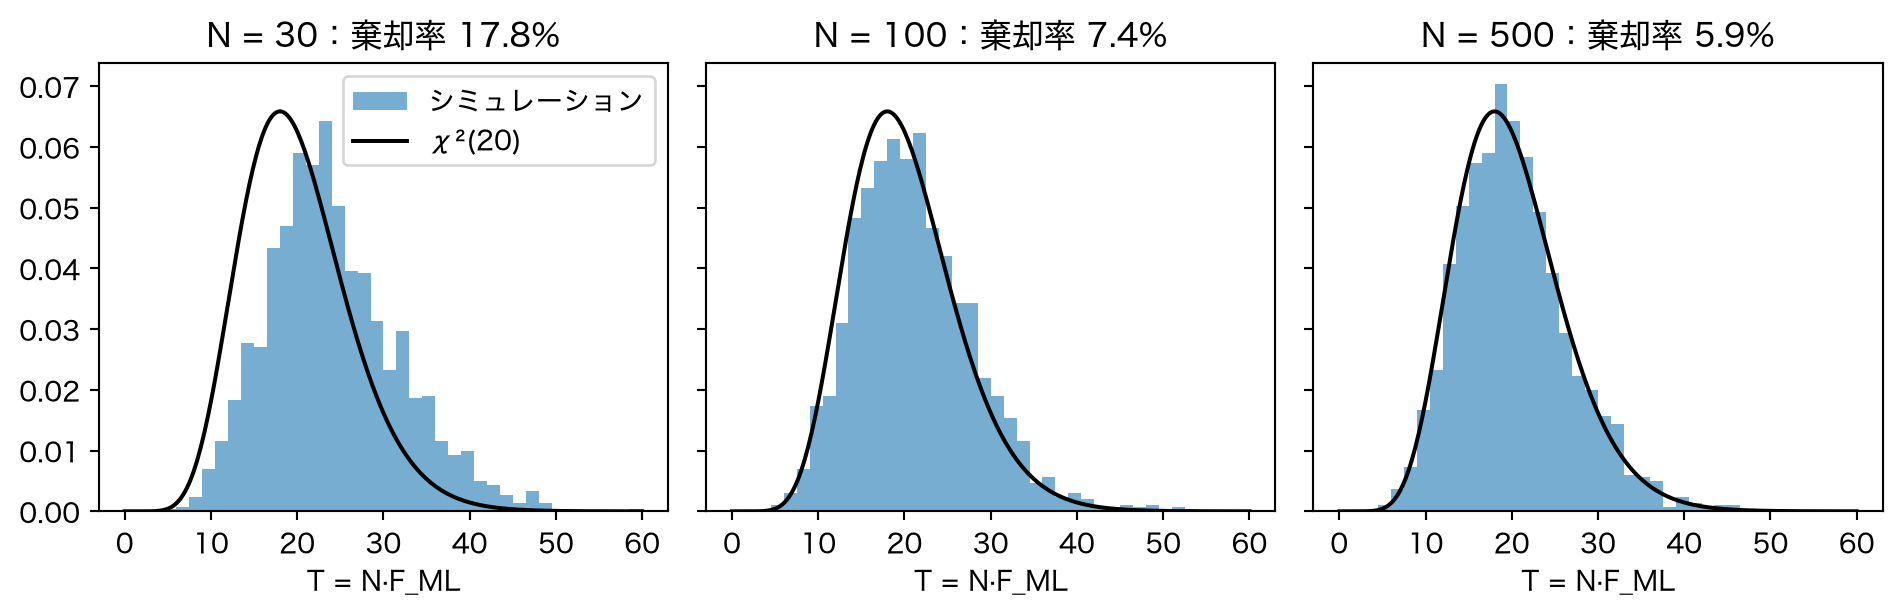
モデルが正しく、正則条件(識別、真の値が内点)のもとで、 \[
T=N\,F_{\mathrm{ML}}(\hat\theta)=2(\ell_1-\ell(\hat\theta))\xrightarrow{d}\chi^2_{\mathrm{df}},\qquad \mathrm{df}=\frac{p(p+1)}2\,(+p)-k .
\]
証明(概略). 飽和モデルの母数 \(\sigma=(\operatorname{vech}\Sigma,\mu)\) を自由に動かす場合と、\(\sigma=\sigma(\theta)\) に制約する場合の尤度比である。 真の値の近くで \(F_{\mathrm{ML}}\approx(s-\sigma)^\top V(s-\sigma)\) (\(s=(\operatorname{vech}S,\bar x)\) 、\(V\) は 1 観測あたりの \(\sigma\) の Fisher 情報行列)と 2 次近似でき、\(\sqrt N(s-\sigma_0)\to N(0,V^{-1})\) 。 \(\theta\) で最小化するのは、\(V\) の内積で \(\sqrt N(s-\sigma_0)\) を接空間 \(\operatorname{span}\{\partial\sigma/\partial\theta\}\) (次元 \(k\) )へ射影することに当たり、残差の 2 乗ノルムは次元 \(\dim\sigma-k\) の \(\chi^2\) に従う(Wilks の定理と同じ議論)。\(\square\)
p 値が小さければ「モデルの共分散構造はデータと合わない」。ただし \(N\) が大きいとわずかなずれでも棄却されるので、次の近似の良さの指標を合わせて見る。
コード
import numpy as npimport matplotlib.pyplot as pltfrom scipy import optimize, stats"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(1 )= 8 = np.linspace(0.8 , 0.5 , p)= np.linalg.cholesky(np.outer(lam, lam) + np.diag(1 - lam** 2 ))= p * (p + 1 ) // 2 - 2 * pdef fml(th, S):"""F_ML とその勾配(補題 2、母数は負荷量と log 独自分散)""" = th[:p], np.exp(th[p:])= np.outer(l, l) + np.diag(psi)= np.linalg.inv(Sig)= np.linalg.slogdet(Sig)[1 ] + np.trace(S @ Si) - np.linalg.slogdet(S)[1 ] - p= Si - Si @ S @ Sireturn f, np.r_[2 * W @ l, np.diag(W) * psi]def stat(n):= rng.normal(size= (n, p)) @ L0.T= np.cov(X, rowvar= False , bias= True )= np.r_[np.sqrt(np.diag(S)) * 0.7 , np.log(np.diag(S) * 0.5 )]return n * optimize.minimize(fml, th0, args= (S,), jac= True , method= "BFGS" , options= {"gtol" : 1e-10 }).fun= plt.subplots(1 , 3 , figsize= (10 , 3.3 ), sharey= True )= np.linspace(0 , 60 , 300 )for ax, n in zip (axes, [30 , 100 , 500 ]):= np.array([stat(n) for _ in range (2000 )])= np.linspace(0 , 60 , 41 ), density= True , alpha= 0.6 , label= "シミュレーション" )"k" , label= f"χ²( { df} )" )f"N = { n} :棄却率 { np. mean(T > stats.chi2.ppf(0.95 , df)):.1%} " )"T = N·F_ML" )0 ].legend(); plt.show()
近似の良さの指標
\(T\) と df をモデル、\(T_b\) と \(\mathrm{df}_b\) を独立モデル (観測変数の分散と平均だけを推定し、共分散をすべて 0 とするモデル。外生の観測変数どうしの共分散は自由のまま)について計算する。
CFI
\(1-\dfrac{\max(T-\mathrm{df},0)}{\max(T-\mathrm{df},\,T_b-\mathrm{df}_b,\,0)}\) 0.95 以上
TLI
\(\dfrac{T_b/\mathrm{df}_b-T/\mathrm{df}}{T_b/\mathrm{df}_b-1}\) 0.95 以上
RMSEA
\(\sqrt{\dfrac{\max(T-\mathrm{df},0)}{\mathrm{df}\cdot N}}\) 0.06 以下(上限 0.08〜0.10 で不良)
SRMR
相関の尺度にした残差 \(\dfrac{s_{ij}-\hat\sigma_{ij}}{\sqrt{s_{ii}s_{jj}}}\) (平均構造があれば平均の残差も)の 2 乗平均の平方根
0.08 以下
目安は特定のシミュレーション条件で導かれたもので、モデルの大きさや負荷量の大きさで意味が変わる。合格ラインとしてではなく、残差や修正の妥当性と合わせて 読む。
RMSEA の信頼区間. モデルが少しだけ間違っている(母集団の不一致 \(F_0\) が \(O(1/N)\) )とき、\(T\) は近似的に非心度 \(\lambda=NF_0\) の非心 \(\chi^2_{\mathrm{df}}(\lambda)\) に従う(Steiger, 1990)。RMSEA は \(\sqrt{F_0/\mathrm{df}}\) の推定量で、 \[
P(\chi^2_{\mathrm{df}}(\lambda_L)\le T)=0.95,\qquad P(\chi^2_{\mathrm{df}}(\lambda_U)\le T)=0.05
\] を満たす \(\lambda\) から 90% 区間 \(\big[\sqrt{\lambda_L/(\mathrm{df}N)},\sqrt{\lambda_U/(\mathrm{df}N)}\big]\) を作る(左辺は \(\lambda\) について単調減少なので二分法で解ける)。 close fit の p 値は \(H_0:\text{RMSEA}\le0.05\) の検定で、\(P(\chi^2_{\mathrm{df}}(0.05^2\,\mathrm{df}\,N)\ge T)\) 。 非心 \(\chi^2\) の分布関数はポアソン重みの混合 \(\sum_j\frac{e^{-\lambda/2}(\lambda/2)^j}{j!}P(\chi^2_{\mathrm{df}+2j}\le T)\) で計算していて、区間の端点は scipy の ncx2 と \(10^{-9}\) の精度で一致する(lavaan は uniroot の既定の精度で解くので \(10^{-6}\) 程度ずれる)。
AIC・BIC は \(-2\ell(\hat\theta)+2k\) 、\(-2\ell(\hat\theta)+k\log N\) (情報量規準の記事 )。同じデータに対する入れ子でないモデルの比較に使う。
標準化解と R²
std.all :すべての変数(潜在変数も)の分散を 1 にしたときの値。負荷量 \(\lambda_{jf}\,\mathrm{sd}(f)/\mathrm{sd}(x_j)\) 、回帰係数も同様、分散は全分散に対する割合。 共分散(x ~~ y)は残差どうしの相関 、つまり \(S_{xy}/\sqrt{S_{xx}S_{yy}}\) (\(S\) は RAM の残差分散)にする(lavaan と同じ)。R² :従属変数(矢印を受ける変数)について \(1-(\text{残差分散})/(\text{全分散})\) 。
分散の推定値が負になる(Heywood ケース)と警告を出す。標本が小さい、因子の指標が少ない、モデルが間違っている、のいずれかであることが多い。
潜在成長曲線モデル
type: "growth" では、切片因子 i と傾き因子 s の負荷量を時点で固定し、観測の切片を 0、因子の平均を自由母数にする:
i =~ 1*t1 + 1*t2 + 1*t3 + 1*t4
s =~ 0*t1 + 1*t2 + 2*t3 + 3*t4
\(E[t_j]=\mu_i+(j-1)\mu_s\) 、\(\Var\) は個人差 \(\Var i,\Var s,\Cov(i,s)\) と測定誤差に分かれる。共変量(i ~ x1)を入れた場合、共変量の平均は自由母数にする(lavaan の growth(fixed.x = FALSE) は共変量の平均も 0 に固定して警告を出すが、それを避けた)。詳しくは別の記事で扱う。
試してみる
国語・英語・社会が「文系」、数学・理科・情報が「理系」の因子(相関 0.4)から生成した例で、2 因子の確認的因子分析を推定する(無料・値の個数 5000 個まで)。モデルを 1 因子(g =~ 国語 + 英語 + 社会 + 数学 + 理科 + 情報)に書き換えると適合度が悪化するのが分かる。
= """ visual =~ x1 + x2 + x3 textual =~ x4 + x5 + x6 speed =~ x7 + x8 + x9 """ = requests.post("https://api.noisymoon.jp/v1/sem/fit" , headers= H,= {"model" : model, "type" : "cfa" , "names" : list (df.columns),"X" : df.where(df.notna(), None ).values.tolist()}).json()"fit" ]["cfi" ], r["fit" ]["rmsea" ], r["fit" ]["rmsea_ci90" ]"parameters" ])[["lhs" , "op" , "rhs" , "est" , "se" , "pvalue" , "std_all" ]]
参考文献
Jöreskog, K. G. (1969). A general approach to confirmatory maximum likelihood factor analysis. Psychometrika , 34, 183–202.
McArdle, J. J. and McDonald, R. P. (1984). Some algebraic properties of the Reticular Action Model for moment structures. British Journal of Mathematical and Statistical Psychology , 37, 234–251.
Bollen, K. A. (1989). Structural Equations with Latent Variables . Wiley.
Steiger, J. H. (1990). Structural model evaluation and modification: An interval estimation approach. Multivariate Behavioral Research , 25, 173–180.
Bentler, P. M. (1990). Comparative fit indexes in structural models. Psychological Bulletin , 107, 238–246.
Tucker, L. R. and Lewis, C. (1973). A reliability coefficient for maximum likelihood factor analysis. Psychometrika , 38, 1–10.
Browne, M. W. and Cudeck, R. (1993). Alternative ways of assessing model fit. In Testing Structural Equation Models , 136–162. Sage.
Hu, L. and Bentler, P. M. (1999). Cutoff criteria for fit indexes in covariance structure analysis. Structural Equation Modeling , 6, 1–55.
Rosseel, Y. (2012). lavaan: An R package for structural equation modeling. Journal of Statistical Software , 48(2), 1–36.