\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
この記事の 4 つの量はひとつながりである。KL 情報量 は「真の分布とモデルの分布の距離」を測り、それを局所的に 2 次近似したものが Fisher 情報量 になる。 Fisher 情報量は最尤推定量のばらつきを決め、そのばらつきから生じる「尤度の見かけの良さ」を補正したものが AIC である。BIC は同じ尤度を、ベイズ的な周辺尤度の近似から導く。
このツールの使い方
KL 情報量 POST /v1/info/kl
必要なデータ 分布族(normal / mvnormal / exponential / poisson / gamma / discrete)と、2 つの分布 P・Q の母数(離散なら確率ベクトル)
前提条件 P と Q は同じ分布族。母数は正しい範囲(分散・率は正、確率ベクトルは合計 1)。対数は自然対数
出力する値 kl_pq = KL(P‖Q)、kl_qp = KL(Q‖P)、jeffreys = 両者の和、kl_pq_bits(ビット単位)。無限大は null
Fisher 情報量 POST /v1/info/fisher
必要なデータ 分布族(normal(μ, σ²) / poisson(λ) / binomial(p、試行回数 trials) / exponential(率) / gamma(形状, 率))と、母数の値と標本の大きさ n 、または標本そのもの
前提条件 分布族が正しいこと、正則条件(台が母数によらない等)。標本を渡した場合は最尤推定値を代入する
出力する値 1 観測あたりの情報行列、n 倍した行列、その逆行列(Cramér–Rao の下限)、標本からは最尤推定値と標準誤差
分布の当てはめと AIC・BIC POST /v1/info/select-distribution
必要なデータ 1 本の標本(3 点以上)。候補の分布を families で指定することもできる
前提条件 観測が互いに独立で同じ分布に従う。連続(正規・対数正規・指数・ガンマ・ワイブル)と離散(ポアソン・負の二項・二項)は尤度の単位が違うので混ぜて比べない 。0 以下の値があれば正の値用の分布は除外
出力する値 分布ごとの最尤推定値・対数尤度・母数の数 k・AIC・BIC・ΔAIC・ΔBIC・赤池重み、AIC と BIC それぞれの最良の分布、除外した分布とその理由
KL 情報量
密度(または確率関数)\(p, q\) について \[
\mathrm{KL}(P\,\|\,Q)=\E_P\!\left[\log\frac{p(X)}{q(X)}\right]=\int p(x)\log\frac{p(x)}{q(x)}\diff x .
\] \(p(x)>0\) で \(q(x)=0\) となる点が正の確率をもつなら \(+\infty\) とする。
\(\mathrm{KL}(P\|Q)\ge0\) で、等号は \(P=Q\) のときに限る。
証明. \(-\log\) は狭義凸なので、イェンセンの不等式から \[
\mathrm{KL}(P\|Q)=\E_P\!\left[-\log\frac{q(X)}{p(X)}\right]\ge-\log\E_P\!\left[\frac{q(X)}{p(X)}\right]=-\log\int_{p>0}q(x)\diff x\ge-\log1=0 .
\] 等号には \(q/p\) が \(P\) についてほとんど確実に定数であることが必要で、積分が 1 であることと合わせて \(p=q\) 。\(\square\)
非対称性. 一般に \(\mathrm{KL}(P\|Q)\ne\mathrm{KL}(Q\|P)\) で、距離の公理は満たさない。例えば \(P=N(0,1)\) 、\(Q=N(1,2^2)\) では \(\mathrm{KL}(P\|Q)=0.443\) 、\(\mathrm{KL}(Q\|P)=1.307\) 。 裾の重い \(Q\) で軽い \(P\) を近似するのは「安い」が、逆は「高い」。
正規分布どうし. \(P=N(\mu_1,\sigma_1^2)\) 、\(Q=N(\mu_2,\sigma_2^2)\) なら \[
\mathrm{KL}(P\|Q)=\E_P\!\left[\log\frac{\sigma_2}{\sigma_1}-\frac{(X-\mu_1)^2}{2\sigma_1^2}+\frac{(X-\mu_2)^2}{2\sigma_2^2}\right]
=\log\frac{\sigma_2}{\sigma_1}+\frac{\sigma_1^2+(\mu_1-\mu_2)^2}{2\sigma_2^2}-\frac12 .
\] (\(\E_P(X-\mu_2)^2=\sigma_1^2+(\mu_1-\mu_2)^2\) を使った。)API の他の分布族も、同様に期待値を計算した閉じた式を使い、数値積分で検算している。
Fisher 情報量
\(X\sim f(x;\theta)\) 、\(\theta\in\R^k\) とし、スコア \(s(\theta;x)=\nabla_\theta\log f(x;\theta)\) を定める。以下、積分と微分の順序交換ができる正則条件を仮定する。
\(\E_\theta[s(\theta;X)]=0\) 。\(I(\theta):=\E_\theta[s\,s^\top]=-\E_\theta\big[\nabla^2_\theta\log f(X;\theta)\big]\) 。
証明. (a) \(\int f\diff x=1\) を \(\theta\) で微分すると \(0=\int\nabla f\diff x=\int f\,\nabla\log f\diff x=\E[s]\) 。 (b) \(\int f\,s^\top\diff x=0\) をさらに微分すると \(0=\int(\nabla f)s^\top+f\,\nabla s^\top\diff x=\E[ss^\top]+\E[\nabla^2\log f]\) 。\(\square\)
例. 正規分布 \(N(\mu,\sigma^2)\) で \(\theta=(\mu,\sigma^2)\) なら \(I=\operatorname{diag}(1/\sigma^2,\ 1/(2\sigma^4))\) 。ポアソン分布では \(I(\lambda)=1/\lambda\) 。 \(n\) 個の独立な観測の情報量は \(nI(\theta)\) である(対数尤度が和になるため)。
\(T(X)\) を \(\psi(\theta)\) の不偏推定量(スカラー、\(k=1\) )とすると \[
\Var_\theta(T)\ge\frac{\psi'(\theta)^2}{nI(\theta)} .
\]
証明. \(S=\sum_{i=1}^n s(\theta;X_i)\) とすると \(\E S=0\) 、\(\Var S=nI\) 。\(\E[T]=\psi(\theta)\) を微分すると \(\psi'(\theta)=\int T\,\partial_\theta\prod f=\E[TS]=\Cov(T,S)\) 。 コーシー・シュワルツの不等式 \(\Cov(T,S)^2\le\Var(T)\Var(S)\) に代入する。\(\square\)
多次元では \(\Cov(T)\succeq (nI)^{-1}\) (行列の意味の不等式、\(\psi(\theta)=\theta\) の場合)。API の crlb はこの右辺である。 最尤推定量 \(\hat\theta\) は正則条件のもとで \(\sqrt n(\hat\theta-\theta)\dto N(0,I(\theta)^{-1})\) となり、漸近的にこの下限を達成する (証明は略、参考文献を参照)。
\[
\mathrm{KL}\big(f_\theta\,\|\,f_{\theta+\delta}\big)=\tfrac12\,\delta^\top I(\theta)\,\delta+o(\|\delta\|^2).
\]
証明. \(\log f_{\theta+\delta}=\log f_\theta+\delta^\top s+\tfrac12\delta^\top\nabla^2\log f_\theta\,\delta+o(\|\delta\|^2)\) を KL の定義に入れて \(\E_\theta\) を取ると、1 次の項は定理 2(a) で消え、2 次の項は定理 2(b) により \(\tfrac12\delta^\top I\delta\) 。\(\square\)
つまり Fisher 情報量は、母数を少し動かしたときに分布がどれだけ「見分けやすく」変わるかの曲率 であり、大きいほど母数を精密に推定できる(定理 3)。
AIC
候補のモデル \(f(x;\theta)\) (母数 \(k\) 個)と、データを生んだ真の分布 \(g\) を考える。良いモデルとは、新しいデータに対する平均的な対数尤度 \[
n\,\E_{g}\big[\log f(Z;\hat\theta)\big]\quad(Z\text{ は } X_{1:n} \text{ と独立な新しい観測})
\] が大きいもの、すなわち \(\mathrm{KL}(g\|f_{\hat\theta})\) が小さいものである。これを最大化した対数尤度 \(\ell(\hat\theta)=\sum\log f(X_i;\hat\theta)\) で推定すると、同じデータを 2 回使っているので高めに偏る 。
モデルが真の分布を含み正則条件が成り立つとき、 \[
\E\Big[\ell(\hat\theta)-n\,\E_g\log f(Z;\hat\theta)\Big]=k+o(1).
\]
証明の筋道. 真の母数 \(\theta_0\) のまわりで展開する。 (i) \(\ell(\hat\theta)-\ell(\theta_0)\approx\tfrac n2(\hat\theta-\theta_0)^\top I(\hat\theta-\theta_0)\) (\(\hat\theta\) で勾配が 0 であることから)。 (ii) \(n\E_g\log f(Z;\theta_0)-n\E_g\log f(Z;\hat\theta)\approx\tfrac n2(\hat\theta-\theta_0)^\top I(\hat\theta-\theta_0)\) (定理 4)。 (iii) \(\E[\ell(\theta_0)]=n\E_g\log f(Z;\theta_0)\) 。 (i)〜(iii) を足すと偏りは \(n(\hat\theta-\theta_0)^\top I(\hat\theta-\theta_0)\) の期待値で、\(\sqrt n(\hat\theta-\theta_0)\dto N(0,I^{-1})\) よりこれは漸近的に \(\chi^2_k\) 、期待値 \(k\) 。\(\square\)
よって期待対数尤度の(近似的な)不偏推定は \(\ell(\hat\theta)-k\) で、これに \(-2\) を掛けたものが \[
\mathrm{AIC}=-2\,\ell(\hat\theta)+2k .
\] AIC が最小のモデルを選ぶ。モデルが真の分布を含まないときは、\(k\) を \(\operatorname{tr}(J I^{-1})\) に置き換えた TIC が一般形になる。
赤池重み. \(\Delta_i=\mathrm{AIC}_i-\min_j\mathrm{AIC}_j\) として \(w_i=e^{-\Delta_i/2}/\sum_je^{-\Delta_j/2}\) 。候補の中で各モデルが「KL の意味で最良」である相対的な重みと解釈される。
BIC
ベイズ的には、モデル \(M\) の周辺尤度 \(p(x_{1:n}\mid M)=\int\prod f(x_i;\theta)\,\pi(\theta)\diff\theta\) が大きいモデルを選ぶ。
正則条件と、\(\hat\theta\) の近くで正かつ連続な事前密度 \(\pi\) のもとで \[
\log p(x_{1:n}\mid M)=\ell(\hat\theta)-\frac k2\log n+O_p(1).
\]
証明の筋道. \(\ell(\theta)\approx\ell(\hat\theta)-\tfrac n2(\theta-\hat\theta)^\top\hat I(\theta-\hat\theta)\) を積分に入れ、正規分布の積分を実行すると \(\int e^{\ell}\pi\,\diff\theta\approx e^{\ell(\hat\theta)}\pi(\hat\theta)(2\pi)^{k/2}\det(n\hat I)^{-1/2}\) 。 対数を取ると \(\det(n\hat I)^{-1/2}\) から \(-\tfrac k2\log n\) が出て、残りは \(n\) によらない。\(\square\)
\(-2\) を掛けて \(O(1)\) の項を捨てたものが \[
\mathrm{BIC}=-2\,\ell(\hat\theta)+k\log n .
\] 罰則 \(k\log n\) は \(n\ge8\) で AIC の \(2k\) より重い。
AIC と BIC の違い
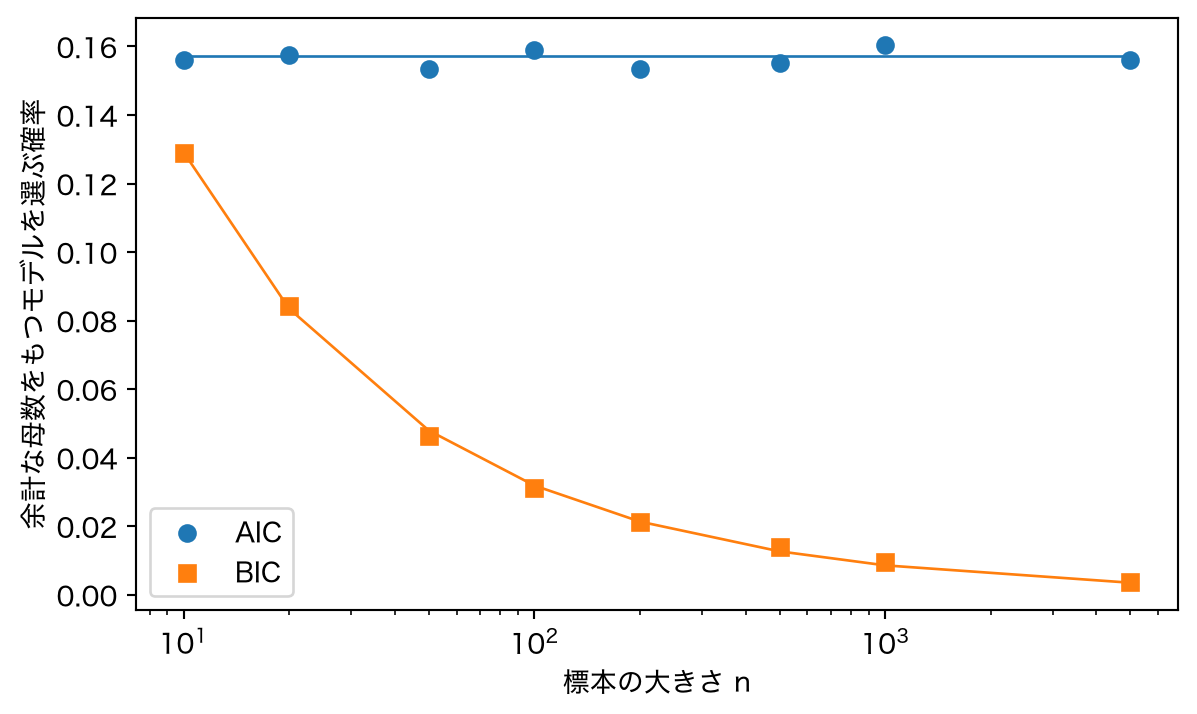
入れ子のモデルで、真のモデルが小さい方のとき、大きい方を誤って選ぶ確率を比べる。\(N(\mu,1)\) の標本で「\(\mu=0\) (\(k=0\) )」と「\(\mu\) 自由(\(k=1\) )」を比べると、 尤度比 \(2(\ell_1-\ell_0)=n\bar X^2\sim\chi^2_1\) (真に \(\mu=0\) のとき)なので、
AIC が大きいモデルを選ぶ確率:\(P(\chi^2_1>2)=0.157\) で、\(n\) によらず一定
BIC が大きいモデルを選ぶ確率:\(P(\chi^2_1>\log n)\to0\) 。BIC は一致性をもつ 。
コード
import numpy as npimport matplotlib.pyplot as pltfrom scipy import stats"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(0 )= np.array([10 , 20 , 50 , 100 , 200 , 500 , 1000 , 5000 ])= [], []for n in ns:= rng.normal(0 , 1 , size= (20000 , n)).mean(axis= 1 )= n * xbar** 2 > 2 ).mean())> np.log(n)).mean())= plt.subplots()2 , 1 )] * len (ns), color= "C0" , lw= 1 )1 ), color= "C1" , lw= 1 )"o" , color= "C0" , label= "AIC" )"s" , color= "C1" , label= "BIC" )"log" )"標本の大きさ n" )"余計な母数をもつモデルを選ぶ確率" )
一方、真のモデルが候補に含まれない、あるいは真の効果が小さく \(n\) とともに増える母数を扱う場面では、AIC は予測の意味で漸近的に効率的 で、BIC は小さすぎるモデルを選びがちになる。 「真のモデルを当てたい」なら BIC、「よく予測したい」なら AIC、が大まかな目安である。
試してみる
標本を入れると、候補の分布を最尤推定して AIC・BIC で比べる(無料・500 点まで)。
= requests.post("https://api.noisymoon.jp/v1/info/select-distribution" , headers= H, json= {"x" : list (x)}).json()for m in r["ranking" ]:print (m["family" ], m["aic" ], m["akaike_weight" ])
参考文献
Kullback, S. and Leibler, R. A. (1951). On information and sufficiency. Annals of Mathematical Statistics , 22, 79–86.
Akaike, H. (1974). A new look at the statistical model identification. IEEE Transactions on Automatic Control , 19, 716–723.
Schwarz, G. (1978). Estimating the dimension of a model. Annals of Statistics , 6, 461–464.
Lehmann, E. L. and Casella, G. (1998). Theory of Point Estimation , 2nd ed. Springer.(Fisher 情報量、Cramér–Rao、最尤推定量の漸近正規性)
小西貞則・北川源四郎 (2004).『情報量規準』朝倉書店.(AIC・TIC・BIC の導出)
Burnham, K. P. and Anderson, D. R. (2002). Model Selection and Multimodel Inference , 2nd ed. Springer.(赤池重み)