\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
このツールの使い方 POST /v1/multivariate/pca
| 必要なデータ |
データ行列 X(行が観測、列が変数。2〜50 変数、欠測は null)、または共分散・相関行列 cov(と標本の大きさ n)。変数名 names(任意) |
| 前提条件 |
変数間の関係が線形であること(非線形な構造は捉えられない)。単位の違う変数を混ぜるなら相関行列(scale: true、既定)。外れ値に敏感。欠測のある行は除く |
| 出力する値 |
固有値・寄与率・累積寄与率、固有ベクトル、主成分負荷量(固有ベクトル × √固有値)、変数と主成分の相関、主成分得点(データを渡したとき)、成分数の目安(Kaiser 基準と平行分析) |
固有ベクトルの符号は数学的には任意なので、各成分で絶対値が最大の要素(同じ大きさなら先頭の変数)が正になるように揃えている。
分散を最大にする方向
中心化したデータ \(X\)(\(n\times p\))の標本共分散行列を \(S=X^\top X/(n-1)\) とする。単位ベクトル \(w\) の方向に射影した得点 \(Xw\) の分散は \(w^\top Sw\) である。
\(\max_{\|w\|=1}w^\top Sw\) は \(S\) の最大固有値 \(\lambda_1\) で、最大を与える \(w\) はその固有ベクトル \(v_1\)。 第 \(j\) 主成分 \(v_j\) は「\(v_1,\dots,v_{j-1}\) と直交する」という条件のもとでの最大化の解で、\(S\) の第 \(j\) 固有ベクトル、分散は \(\lambda_j\)。
証明. ラグランジュ関数 \(w^\top Sw-\lambda(w^\top w-1)\) を \(w\) で微分して 0 とおくと \(Sw=\lambda w\)。このとき \(w^\top Sw=\lambda\) なので、最大は最大固有値。 \(S\) は対称なので固有ベクトルは互いに直交にとれ、\(S=\sum_j\lambda_jv_jv_j^\top\)。\(w\perp v_1,\dots,v_{j-1}\) なら \(w=\sum_{i\ge j}c_iv_i\)、\(\sum c_i^2=1\) で \(w^\top Sw=\sum_{i\ge j}\lambda_ic_i^2\le\lambda_j\)。\(\square\)
寄与率 \(\lambda_j/\sum_i\lambda_i\) は、全分散(\(\operatorname{tr}S\))のうち第 \(j\) 主成分が説明する割合である。 主成分負荷量 \(v_j\sqrt{\lambda_j}\) は、相関行列で分析したとき、変数と主成分得点の相関に一致する(\(\Cov(x,Xv_j)=Sv_j=\lambda_jv_j\) を、\(\operatorname{sd}(x)=1\) と \(\operatorname{sd}(Xv_j)=\sqrt{\lambda_j}\) で割る)。
特異値分解と最良の低ランク近似
中心化したデータを特異値分解 \(X=UDV^\top\)(\(D=\operatorname{diag}(d_1\ge d_2\ge\cdots)\))すると、 \[
S=\frac{X^\top X}{n-1}=V\frac{D^2}{n-1}V^\top
\] なので、\(V\) の列が主成分の方向、\(\lambda_j=d_j^2/(n-1)\)、主成分得点は \(XV=UD\) である。
階数 \(k\) 以下の行列 \(B\) のうち \(\|X-B\|_F\) を最小にするのは \(X_k=\sum_{j\le k}d_ju_jv_j^\top\) で、最小値は \(\big(\sum_{j>k}d_j^2\big)^{1/2}\)。
証明(概略). 階数 \(k\) の \(B\) について、特異値の不等式(Weyl)\(\sigma_{i+k}(X)\le\sigma_i(X-B)+\sigma_{k+1}(B)=\sigma_i(X-B)\) から \(\|X-B\|_F^2=\sum_i\sigma_i(X-B)^2\ge\sum_{i}\sigma_{i+k}(X)^2=\sum_{j>k}d_j^2\)。等号は \(B=X_k\) で達成される。\(\square\)
つまり 最初の \(k\) 個の主成分は、データを \(k\) 次元で近似したときの二乗誤差を最小にする。累積寄与率 \(\sum_{j\le k}\lambda_j/\sum\lambda_j=1-\|X-X_k\|_F^2/\|X\|_F^2\) は、この近似で失われない割合である。
成分数の決め方
- スクリープロット:固有値を並べた図で、急に平らになる「肘」の手前までを採る(主観的)。
- Kaiser 基準:相関行列の固有値が 1(変数 1 個分の分散)を超える成分を採る。変数が多いと採りすぎる傾向がある。
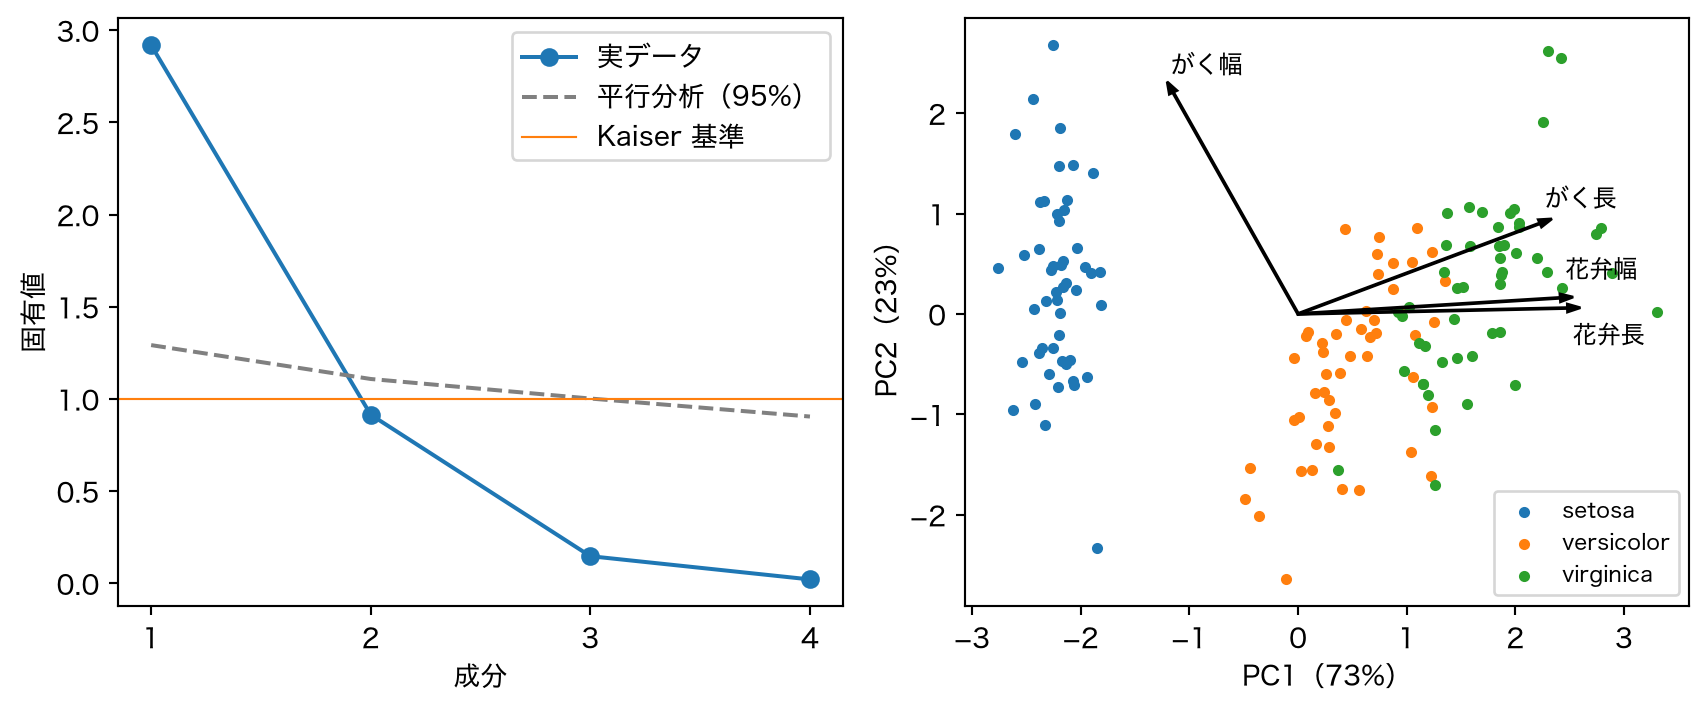
- 平行分析(Horn, 1965):同じ大きさの独立な正規乱数データの相関行列の固有値(ここでは 95 パーセント点)と比べ、実データの固有値がそれを上回る成分だけを採る。偶然の相関で生じる固有値の大きさを差し引く考え方で、3 つの中では最も推奨されることが多い。
コード
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris

plt.rcParams["font.family"] = ["Hiragino Sans", "sans-serif"]
iris = load_iris()
X = iris.data
Z = (X - X.mean(0)) / X.std(0, ddof=1)
vals, vecs = np.linalg.eigh(np.corrcoef(X, rowvar=False))
vals, vecs = vals[::-1], vecs[:, ::-1]
vecs *= np.sign(vecs[np.argmax(np.abs(vecs), axis=0), range(4)])
rng = np.random.default_rng(0)
sim = np.array([np.sort(np.linalg.eigvalsh(np.corrcoef(rng.normal(size=X.shape), rowvar=False)))[::-1] for _ in range(200)])
q95 = np.quantile(sim, 0.95, axis=0)

fig, (a1, a2) = plt.subplots(1, 2, figsize=(9, 3.8))
a1.plot(range(1, 5), vals, "o-", label="実データ")
a1.plot(range(1, 5), q95, "--", color="gray", label="平行分析(95%)")
a1.axhline(1, color="C1", lw=0.8, label="Kaiser 基準")
a1.set_xticks(range(1, 5)); a1.set_xlabel("成分"); a1.set_ylabel("固有値"); a1.legend()
S = Z @ vecs
for k, name in enumerate(iris.target_names):
    a2.scatter(S[iris.target == k, 0], S[iris.target == k, 1], s=10, label=name)
L = vecs[:, :2] * np.sqrt(vals[:2])
for j, (fname, dy) in enumerate(zip(["がく長", "がく幅", "花弁長", "花弁幅"], [0.15, 0.15, -0.35, 0.2])):
    a2.arrow(0, 0, 2.5 * L[j, 0], 2.5 * L[j, 1], color="k", width=0.01, head_width=0.08)
    a2.text(2.55 * L[j, 0], 2.55 * L[j, 1] + dy, fname, fontsize=9)  # 花弁長と花弁幅の矢印がほぼ重なるので上下にずらす
a2.set_xlabel(f"PC1({vals[0] / 4:.0%})"); a2.set_ylabel(f"PC2({vals[1] / 4:.0%})"); a2.legend(fontsize=8)
plt.tight_layout(); plt.show()
アヤメでは第 1 主成分だけで約 73% を説明し、平行分析も第 1 成分だけを採る。第 1 主成分は「花の大きさ」(がく幅以外の 3 変数が強く正)、第 2 主成分は主にがく幅を表す。
PCA と因子分析・SEM の違い
見た目は似ているが、モデルの向きが逆である。
| 式 |
\(\text{主成分}=\sum_jv_jx_j\)(観測の合成) |
\(x=\Lambda f+\varepsilon\)(観測は因子と誤差から生じる) |
因子分析+潜在変数どうしの回帰 |
| 誤差 |
仮定しない(全分散を説明しようとする) |
変数ごとの独自性 \(\Psi\) を分ける |
同左、構造にも誤差 |
| 共分散のモデル |
なし(固有値分解するだけ) |
\(\Sigma=\Lambda\Lambda^\top+\Psi\) |
\(\Sigma(\theta)\)(パス図から決まる) |
| 目的 |
次元削減・要約 |
観測の背後の潜在構造の推定 |
仮説モデルの検証 |
| 検定・適合度 |
なし |
χ²(ML)、CFA では適合度指標 |
χ²・CFI・RMSEA など |
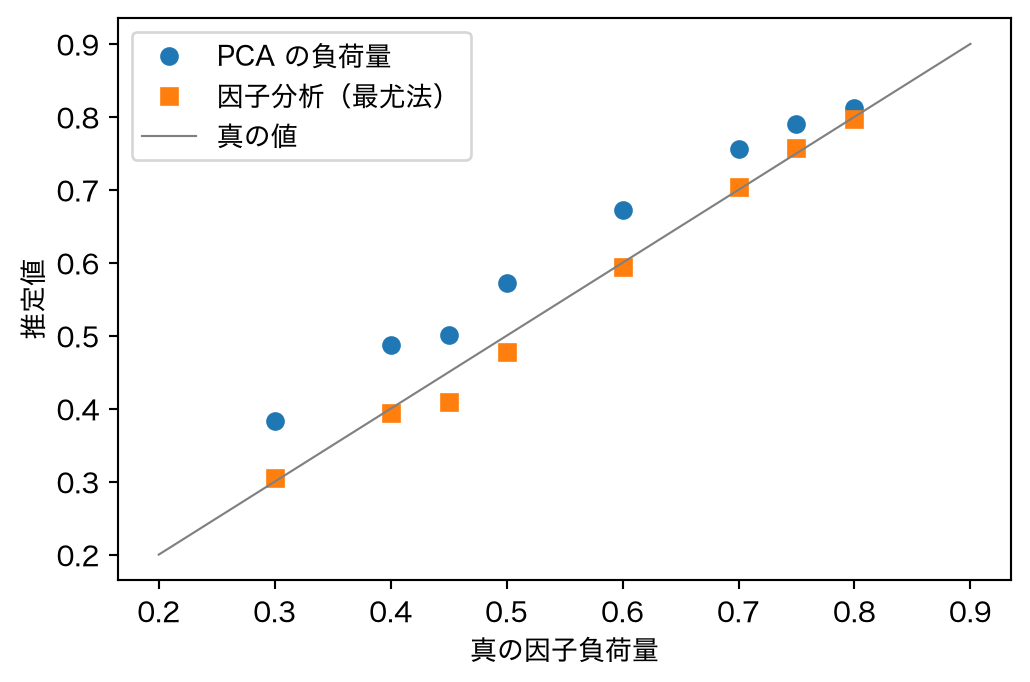
独自性(ノイズ)が大きいと、PCA は誤差の分散まで成分に取り込むため、負荷量が真の因子負荷量より大きく出る。
コード
from sklearn.decomposition import FactorAnalysis

true_l = np.array([0.8, 0.75, 0.7, 0.6, 0.5, 0.45, 0.4, 0.3])
n = 2000
f = rng.normal(size=(n, 1))
Xf = f @ true_l[None, :] + rng.normal(size=(n, 8)) * np.sqrt(1 - true_l**2)
Zf = (Xf - Xf.mean(0)) / Xf.std(0, ddof=1)
v, w = np.linalg.eigh(np.corrcoef(Zf, rowvar=False))
pca_l = np.abs(w[:, -1] * np.sqrt(v[-1]))
fa_l = np.abs(FactorAnalysis(n_components=1).fit(Zf).components_[0])
fig, ax = plt.subplots(figsize=(6, 3.8))
ax.plot(true_l, pca_l, "o", label="PCA の負荷量")
ax.plot(true_l, fa_l, "s", label="因子分析(最尤法)")
ax.plot([0.2, 0.9], [0.2, 0.9], color="gray", lw=0.8, label="真の値")
ax.set_xlabel("真の因子負荷量"); ax.set_ylabel("推定値"); ax.legend(); plt.show()
潜在変数を仮定して構造を検証したい場合は、PCA ではなく因子分析や SEM を使う(構造方程式モデリングの記事)。
試してみる
CSV(1 行目が見出しでもよい)を貼り付けると、相関行列による PCA を計算する(無料・値の個数 5000 個まで)。
r = requests.post("https://api.noisymoon.jp/v1/multivariate/pca", headers=H,
                  json={"X": df.values.tolist(), "names": list(df.columns)}).json()
r["explained_ratio"], r["loadings"], r["parallel_analysis"]["n_components"]
参考文献
- Pearson, K. (1901). On lines and planes of closest fit to systems of points in space. Philosophical Magazine, 2, 559–572.
- Hotelling, H. (1933). Analysis of a complex of statistical variables into principal components. Journal of Educational Psychology, 24, 417–441.
- Eckart, C. and Young, G. (1936). The approximation of one matrix by another of lower rank. Psychometrika, 1, 211–218.
- Horn, J. L. (1965). A rationale and test for the number of factors in factor analysis. Psychometrika, 30, 179–185.
- Jolliffe, I. T. (2002). Principal Component Analysis, 2nd ed. Springer.