\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Corr}{\operatorname{Corr}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
このツールの使い方 POST /v1/sem/growth
必要なデータ 1 人 1 行、時点ごとに 1 列のデータ行列 X と列名 names(3〜20 時点、欠測は null)。時点の値 times(既定は 0, 1, 2, …)、形 shape(linear・quadratic・latent_basis)、時間によらない共変量 covariates(任意)
前提条件 全員が同じ時点 で測られていること(時点が人によって違うなら混合モデルを使う)。観測が多変量正規で人どうし独立(最尤法)。欠測はリストワイズ除去。2 次は 4 時点以上が必要。標本はおおむね 100〜200 以上が目安
出力する値 成長因子(切片 i・傾き s・2 次 q)の平均・分散・共分散と標準誤差、モデルの平均の軌跡、形の比較(各形の χ²・AIC・BIC と、入れ子の組の χ² 差の検定)、個人の因子得点(回帰法)、SEM と同じ母数表と適合度。生成した lavaan の構文も返す
推定は SEM の記事 と同じ最尤法で、R の lavaan(growth())と 5 つのモデル(線形、2 次、latent basis、共変量+残差の等分散、5 時点・不等間隔・欠測あり)で突き合わせている。因子得点は lavPredict()、形の比較は lavTestLRT() と一致する。
モデル
\(i\) さんの時点 \(t_j\) での観測 \(y_{ij}\) (\(j=1,\dots,T\) )を、個人ごとの切片と傾きで表す: \[
y_{ij}=\eta_{0i}+\lambda_j\,\eta_{1i}+\varepsilon_{ij},\qquad
\begin{pmatrix}\eta_{0i}\\\eta_{1i}\end{pmatrix}\sim N\!\left(\begin{pmatrix}\alpha_0\\\alpha_1\end{pmatrix},\Psi\right),\quad
\varepsilon_{ij}\sim N(0,\theta_j).
\] \(\lambda_j=t_j\) なら線形の成長である。\(\eta_0,\eta_1\) を潜在変数(因子)と見ると、負荷量をすべて固定した確認的因子分析になる: \[
\Lambda=\begin{pmatrix}1&t_1\\\vdots&\vdots\\1&t_T\end{pmatrix},\qquad
\mu=\Lambda\alpha,\qquad \Sigma=\Lambda\Psi\Lambda^\top+\Theta .
\] 平均の軌跡は \(\alpha\) で、個人差は \(\Psi\) (切片の分散・傾きの分散・その共分散)で表される。lavaan の構文では
i =~ 1*y1 + 1*y2 + 1*y3 + 1*y4
s =~ 0*y1 + 1*y2 + 2*y3 + 3*y4
と書き、観測の切片を 0 に固定して因子の平均を自由母数にする(type: "growth")。
同じモデルは、ランダム切片・ランダム傾きの線形混合モデル \(y_{ij}=\beta_0+\beta_1t_j+b_{0i}+b_{1i}t_j+\varepsilon_{ij}\) でもある。 全員が同じ時点で測られていれば、\(y_i\) の周辺分布はどちらも \(N(\Lambda\alpha,\Lambda\Psi\Lambda^\top+\Theta)\) なので、同じ仮定(混合モデルの既定は残差分散が時点によらない=equal_residuals: true)のもとで同じ最尤推定値を与える(混合モデルの既定の REML とは分散の推定が少し違う)。 SEM として書く利点は、残差分散を時点ごとに変える、軌跡の形を推定する(latent basis)、成長因子を別の潜在変数の予測に使う、適合度で検討する、などが自然にできること。
時点の符号化
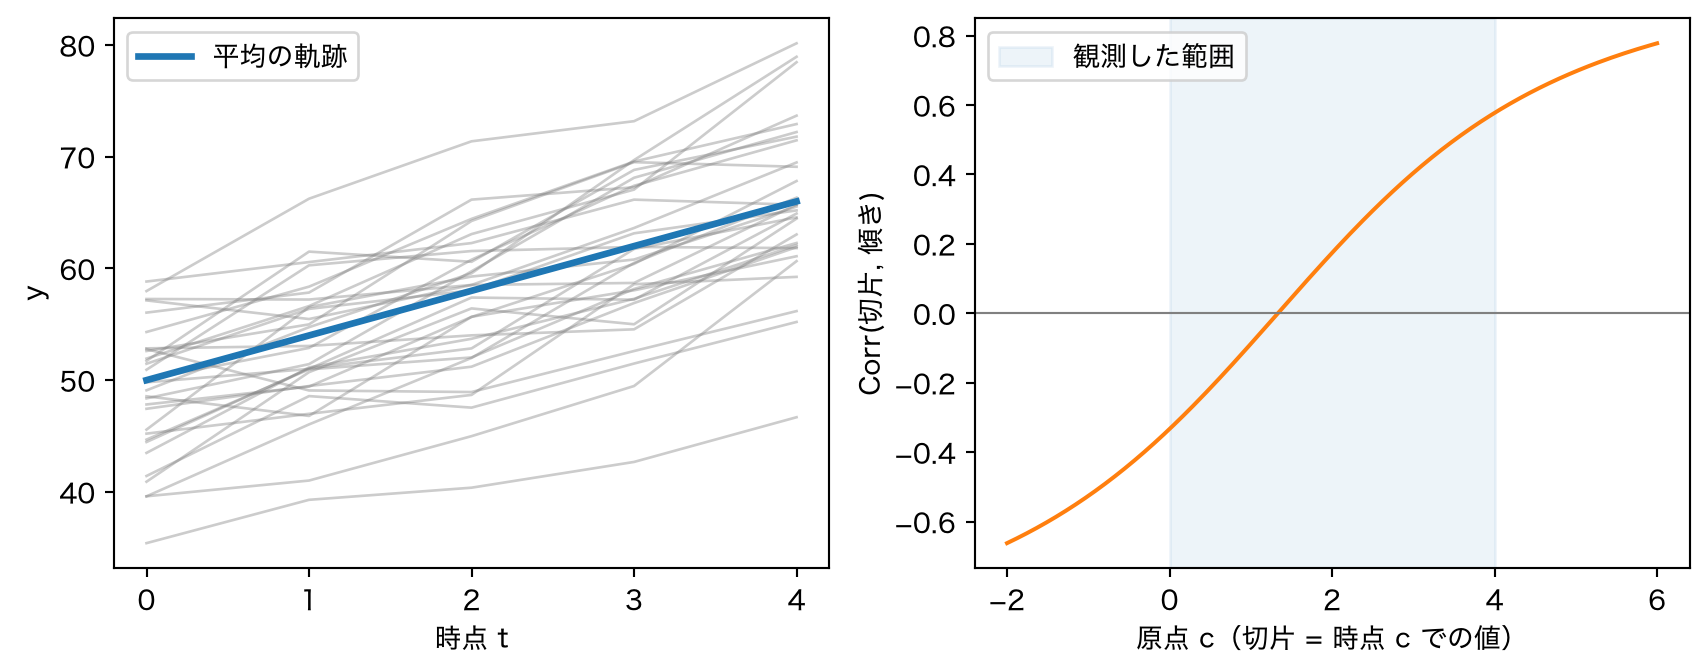
切片 \(\eta_0\) は「\(t=0\) での値」である。時点をずらすと、切片の意味とその分散、傾きとの共分散が変わる。
時点を \(t'_j=t_j-c\) に置き換えたモデルは元のモデルと同値で(同じ \(\Sigma,\mu\) の集合を表し、同じ \(\chi^2\) を与える)、 \[
\eta'_0=\eta_0+c\,\eta_1,\qquad \Var\eta'_0=\psi_{00}+2c\,\psi_{01}+c^2\psi_{11},\qquad \Cov(\eta'_0,\eta_1)=\psi_{01}+c\,\psi_{11}.
\]
証明. \(\eta_0+t_j\eta_1=(\eta_0+c\eta_1)+(t_j-c)\eta_1\) 。\(\Lambda'=\Lambda C\) (\(C=\begin{pmatrix}1&c\\0&1\end{pmatrix}\) は正則)なので、\(\alpha'=C^{-1}\alpha\) 、\(\Psi'=C^{-1}\Psi C^{-\top}\) とすれば \(\Lambda'\alpha'=\Lambda\alpha\) 、\(\Lambda'\Psi'\Lambda'^\top=\Lambda\Psi\Lambda^\top\) 。逆も同様。\(C^{-1}\) を \(\eta\) に掛けた形が上の式。\(\square\)
\(\Var(\eta_0+c\eta_1)\) は時点 \(c\) での真の値の個人差なので、相関 \(\Corr(\eta'_0,\eta_1)=\sqrt{\psi_{11}}(c-c^*)/\sqrt{\psi_{11}(c-c^*)^2+\det\Psi/\psi_{11}}\) (\(c^*=-\psi_{01}/\psi_{11}\) )は、個人差が最小になる時点 \(c^*\) で 0、そこから離れるほど \(\pm1\) に近づく。 つまり「切片と傾きの相関」は時点の原点の取り方で決まる量で、それ自体に実質的な意味はない。関心のある時点(開始時、最終時、中央)を 0 にして解釈する。
コード
import numpy as npimport matplotlib.pyplot as plt"font.family" ] = ["Hiragino Sans" , "sans-serif" ]= np.random.default_rng(2 )= np.arange(5.0 )= np.array([50.0 , 4.0 ])= np.array([[36.0 , - 3.0 ], [- 3.0 , 2.25 ]])= rng.multivariate_normal(alpha, Psi, size= 100 )= eta[:, [0 ]] + eta[:, [1 ]] * t + rng.normal(0 , 2 , size= (100 , 5 ))= plt.subplots(1 , 2 , figsize= (9 , 3.6 ))for y in Y[:30 ]:= "gray" , alpha= 0.4 , lw= 1 )0 ] + alpha[1 ] * t, "C0" , lw= 2.5 , label= "平均の軌跡" )"時点 t" ); a1.set_ylabel("y" ); a1.legend()= np.linspace(- 2 , 6 , 200 )= Psi[0 , 0 ] + 2 * c * Psi[0 , 1 ] + c** 2 * Psi[1 , 1 ]= Psi[0 , 1 ] + c * Psi[1 , 1 ]/ np.sqrt(var0 * Psi[1 , 1 ]), "C1" )0 , color= "gray" , lw= 0.8 )0 , 4 , color= "C0" , alpha= 0.08 , label= "観測した範囲" )"原点 c(切片 = 時点 c での値)" ); a2.set_ylabel("Corr(切片, 傾き)" ); a2.legend(); plt.show()
形のバリエーション
切片のみ(成長なし)
\(\Lambda=\mathbf 1\) 1 + 1
2
線形
\((1,\,t_j)\) 2 + 3
3
2 次
\((1,\,t_j,\,t_j^2)\) 3 + 6
4
latent basis
\((1,\,\lambda_j)\) 、\(\lambda_1=t_1,\ \lambda_2=t_2\) に固定し、残りを推定2 + 3 + \((T-2)\)
3
latent basis (自由な時間係数)は、軌跡の形を決めずにデータから推定する。\(\lambda_j\) は「時点 \(t_1\) から \(t_2\) までの変化を 1 単位としたとき、\(t_j\) までに何単位変化したか」と読める。すべての \(\lambda_j=t_j\) なら線形なので、線形モデルは latent basis の特別な場合(入れ子)である。
識別. 自由母数の数が積率の数 \(T(T+1)/2+T\) 以下であることが必要(残差分散を時点ごとに推定すると、2 次は \(9+T\le T(T+3)/2\) から \(T\ge4\) )。latent basis で 2 つの係数を固定するのは、\(\eta_1\) の尺度と原点を決めるためで、固定しないと \(\eta_1\to a\eta_1\) と \(\lambda\to\lambda/a\) の不定性が残る。
共変量 :covariates に指定した変数(性別・処置など、時間によらないもの)にすべての成長因子を回帰する(条件付き成長モデル)。このとき因子の平均は「共変量が 0 のときの値」になる。共変量の平均と分散は推定する(lavaan の growth(fixed.x = FALSE) は共変量の平均を 0 に固定して警告を出すが、それを避けた)。
残差の等分散 (equal_residuals):\(\theta_1=\dots=\theta_T\) の制約。時点数が少ないときや、端の時点の残差分散が負になる(Heywood ケース)ときに使われる。混合モデルの既定と同じ仮定になる。
形の比較
compare_shapes: true(既定)では、同じデータで切片のみ・線形・2 次・latent basis を推定し、入れ子の組について χ² 差の検定 \[
\Delta\chi^2=\chi^2_{\text{制約あり}}-\chi^2_{\text{一般}}\ \sim\ \chi^2_{\Delta\mathrm{df}}\quad(\text{制約が正しいとき、漸近的に})
\] をする(組は 切片のみ → 線形、線形 → 2 次、線形 → latent basis)。どれも同じ観測変数・同じ標本の尤度比なので、SEM の記事 の定理がそのまま使える。入れ子でない組(2 次と latent basis)は AIC・BIC で比べる。
切片のみ → 線形 の比較では、傾きの分散 \(\psi_{11}\ge0\) が 0 かどうかも検定している。帰無仮説の値が母数空間の境界にあるので、Wilks の定理の正則条件が崩れ、\(\Delta\chi^2\) の漸近分布は \(\chi^2_{\Delta\mathrm{df}}\) ではなく χ² 分布の混合になる(Self & Liang, 1987; Stram & Lee, 1994)。 表の p 値は \(\chi^2_{\Delta\mathrm{df}}\) で計算しているので保守的 (大きめ)になる。線形 → 2 次 も \(q\) の分散について同じことが起きる。平均の軌跡の形だけを問いたいなら、母数表の \(q\) の平均(q ~1)の z 検定を見る方法もある。
因子得点(個人の軌跡)
各人の成長因子の推定値は、観測 \(y_i\) が与えられたときの条件付き期待値(回帰法 、lavaan の lavPredict() の既定): \[
\hat\eta_i=E[\eta\mid y_i]=\alpha+\Psi\Lambda^\top\Sigma^{-1}(y_i-\Lambda\alpha).
\] 共変量がある場合は、共変量も含めた観測全体で条件づける。
\(\Theta\) が正定値なら、\(\hat\eta_i-\alpha=(\Psi^{-1}+\Lambda^\top\Theta^{-1}\Lambda)^{-1}\Lambda^\top\Theta^{-1}(y_i-\Lambda\alpha)\) 。 とくに個人ごとの最小二乗推定 \(\tilde\eta_i=(\Lambda^\top\Theta^{-1}\Lambda)^{-1}\Lambda^\top\Theta^{-1}y_i\) を使うと \(\hat\eta_i-\alpha=(\Psi^{-1}+\Lambda^\top\Theta^{-1}\Lambda)^{-1}\Lambda^\top\Theta^{-1}\Lambda\,(\tilde\eta_i-\alpha)\) で、個人の推定を平均の方へ引き寄せる。
証明. Woodbury の公式 \(\Sigma^{-1}=\Theta^{-1}-\Theta^{-1}\Lambda(\Psi^{-1}+\Lambda^\top\Theta^{-1}\Lambda)^{-1}\Lambda^\top\Theta^{-1}\) を代入すると \(\Psi\Lambda^\top\Sigma^{-1}=\Psi\big[I-\Lambda^\top\Theta^{-1}\Lambda(\Psi^{-1}+\Lambda^\top\Theta^{-1}\Lambda)^{-1}\big]\Lambda^\top\Theta^{-1}\) 、 \([\ ]\) の中は \(\Psi^{-1}(\Psi^{-1}+\Lambda^\top\Theta^{-1}\Lambda)^{-1}\) に等しいので前半が出る。後半は \(\Lambda^\top\Theta^{-1}(y_i-\Lambda\alpha)=\Lambda^\top\Theta^{-1}\Lambda(\tilde\eta_i-\alpha)\) から。\(\square\)
測定誤差が大きい(\(\Theta\) が大きい)人や時点の少ない設計ほど、得点は平均に強く縮む。そのため因子得点の分散は \(\Psi\) より小さく、得点を別の分析の従属変数に使うと関係が過小評価されることがある(Skrondal & Laake, 2001)。成長因子と外部変数の関係は、得点を経由せずにモデルの中で推定する(covariates を使う、または /v1/sem/fit で構文を書く)方がよい。
試してみる
伸びが鈍っていく曲線(2 次)から、曲がり方にも個人差があるように生成した 5 時点・200 人のデータで、軌跡の形を比べる(無料・値の個数 5000 個まで)。形の比較の表では、2 次の χ² と AIC が線形・latent basis より大きく下がる。平均の軌跡の曲がりだけなら latent basis でも表せるが、曲がり方の個人差(\(q\) の分散)は 2 次でないと表せないためである。
= requests.post("https://api.noisymoon.jp/v1/sem/growth" , headers= H,= {"names" : ["y1" , "y2" , "y3" , "y4" ], "X" : df.where(df.notna(), None ).values.tolist(),"times" : [0 , 1 , 2 , 3 ], "shape" : "linear" , "covariates" : []}).json()"trajectory" ]["factor_means" ], r["comparison" ]["lrt" ]print (r["syntax" ]) # 同じモデルを /v1/sem/fit で拡張するときの出発点
参考文献
Meredith, W. and Tisak, J. (1990). Latent curve analysis. Psychometrika , 55, 107–122.
McArdle, J. J. and Epstein, D. (1987). Latent growth curves within developmental structural equation models. Child Development , 58, 110–133.
Self, S. G. and Liang, K.-Y. (1987). Asymptotic properties of maximum likelihood estimators and likelihood ratio tests under nonstandard conditions. Journal of the American Statistical Association , 82, 605–610.
Stram, D. O. and Lee, J. W. (1994). Variance components testing in the longitudinal mixed effects model. Biometrics , 50, 1171–1177.
Skrondal, A. and Laake, P. (2001). Regression among factor scores. Psychometrika , 66, 563–575.
Biesanz, J. C., Deeb-Sossa, N., Papadakis, A. A., Bollen, K. A. and Curran, P. J. (2004). The role of coding time in estimating and interpreting growth curve models. Psychological Methods , 9, 30–52.
Bollen, K. A. and Curran, P. J. (2006). Latent Curve Models: A Structural Equation Perspective . Wiley.