\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
何を調べる検定か
時系列 \(y_t\) が 単位根(unit root)を持つか、つまりランダムウォークのように ショックが永久に残る過程かどうかを調べる。
最も簡単な AR(1) で考える。 \[
y_t = \phi\, y_{t-1} + \varepsilon_t, \qquad \varepsilon_t \iid (0, \sigma^2).
\]
- \(|\phi| < 1\) なら定常。ショックは指数的に減衰する。
- \(\phi = 1\) ならランダムウォーク \(y_t = y_0 + \sum_{s=1}^t \varepsilon_s\)。\(\Var(y_t) = t\sigma^2\) で発散する。
両辺から \(y_{t-1}\) を引き、\(\gamma = \phi - 1\) とおくと検定しやすい形になる。 \[
\Delta y_t = \gamma\, y_{t-1} + \varepsilon_t .
\]
検定の組み立て
ADF 検定は、確定項と \(\Delta y\) のラグを加えた次の回帰を OLS で推定する。 \[
\Delta y_t = \underbrace{\alpha + \beta t}_{\text{確定項}} + \gamma\, y_{t-1}
+ \sum_{i=1}^{p} \delta_i\, \Delta y_{t-i} + \varepsilon_t .
\]
| \(H_0: \gamma = 0\) |
単位根あり(非定常) |
| \(H_1: \gamma < 0\) |
単位根なし(定常。確定項があればトレンド定常) |
検定統計量は通常の \(t\) 値と同じ形をしている。 \[
\tau = \frac{\hat\gamma}{\operatorname{se}(\hat\gamma)} .
\]
ラグ \(\sum \delta_i \Delta y_{t-i}\) は、誤差の系列相関を吸収して \(\varepsilon_t\) を白色雑音に近づけるために入れる。 \(p\) は AIC や BIC で選ぶのが普通。
確定項の入れ方で3通りに分かれ、それぞれ臨界値が違う。
| 1 |
なし |
0 のまわりの定常 |
\(-1.95\) |
| 2 |
定数 \(\alpha\) |
平均 \(\ne 0\) の定常 |
\(-2.86\) |
| 3 |
定数 \(\alpha\) + トレンド \(\beta t\) |
トレンド定常 |
\(-3.41\) |
なぜ正規分布の臨界値を使えないのか
\(H_0\) の下では \(y_{t-1}\) が非定常なので、通常の中心極限定理が使えない。 \(\tau\) は標準正規分布には収束せず、ブラウン運動 \(W(r)\) の汎関数に収束する(ケース1)。 \[
\tau \;\dto\; \frac{\tfrac12\left(W(1)^2 - 1\right)}{\left(\int_0^1 W(r)^2 \diff r\right)^{1/2}} .
\]
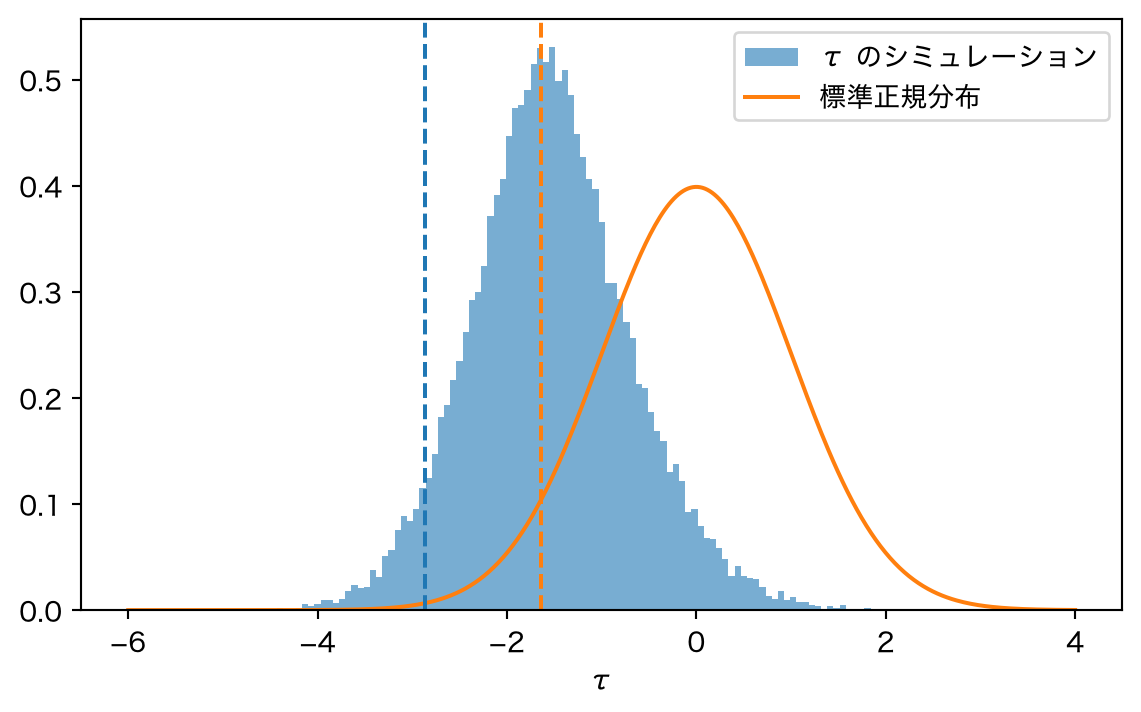
この分布は左に大きくずれている。\(H_0\) の下で \(\tau\) をシミュレーションすると確かめられる(ケース2、\(T = 200\))。
コード
import numpy as np
import matplotlib.pyplot as plt
from scipy import stats

plt.rcParams["font.family"] = ["Hiragino Sans", "sans-serif"]
rng = np.random.default_rng(0)

def df_tau(y):
    """ケース2(定数あり、ラグなし)の DF 統計量を行ごとに計算する。y: (R, T)"""
    dy = np.diff(y, axis=1)
    x = y[:, :-1]
    xc = x - x.mean(axis=1, keepdims=True)
    dyc = dy - dy.mean(axis=1, keepdims=True)
    sxx = (xc**2).sum(axis=1)
    g = (xc * dyc).sum(axis=1) / sxx
    resid = dyc - g[:, None] * xc
    n = dy.shape[1]
    s2 = (resid**2).sum(axis=1) / (n - 2)
    return g / np.sqrt(s2 / sxx)

R, T = 20000, 200
y = np.cumsum(rng.standard_normal((R, T)), axis=1)
tau = df_tau(y)

grid = np.linspace(-6, 4, 400)
fig, ax = plt.subplots()
ax.hist(tau, bins=120, density=True, alpha=0.6, label="τ のシミュレーション")
ax.plot(grid, stats.norm.pdf(grid), label="標準正規分布")
q_tau = np.quantile(tau, 0.05)
ax.axvline(q_tau, ls="--", color="C0")
ax.axvline(stats.norm.ppf(0.05), ls="--", color="C1")
ax.set_xlabel("τ")
ax.legend()
plt.show()
print(f"シミュレーションの 5% 点: {q_tau:.2f}   標準正規の 5% 点: {stats.norm.ppf(0.05):.2f}")
シミュレーションの 5% 点: -2.87 標準正規の 5% 点: -1.64
標準正規の \(-1.645\) で判定すると、単位根があるのに「定常」と判定する誤りが 5% を大きく超えてしまう。
使ってみる
statsmodels の adfuller で、ランダムウォークと定常な AR(1) を比べる。
コード
from statsmodels.tsa.stattools import adfuller

rng = np.random.default_rng(1)
T = 300
eps = rng.standard_normal(T)

def ar1(phi):
    y = np.zeros(T)
    for t in range(1, T):
        y[t] = phi * y[t - 1] + eps[t]
    return y

for name, phi in [("ランダムウォーク φ=1", 1.0), ("AR(1) φ=0.8", 0.8), ("AR(1) φ=0.97", 0.97)]:
    stat, p, lag, n, crit, _ = adfuller(ar1(phi), regression="c", autolag="AIC")
    print(f"{name:18s} τ = {stat:6.2f}  p = {p:.3f}  ラグ = {lag}")
ランダムウォーク φ=1       τ =   0.34  p = 0.979  ラグ = 8
AR(1) φ=0.8        τ =  -5.03  p = 0.000  ラグ = 8
AR(1) φ=0.97       τ =  -2.30  p = 0.171  ラグ = 8
\(\phi = 0.97\) は定常なのに、\(p\) 値が大きく出やすい。次の節で見るように、単位根に近い定常過程を見分ける力は弱い。
検出力が低い
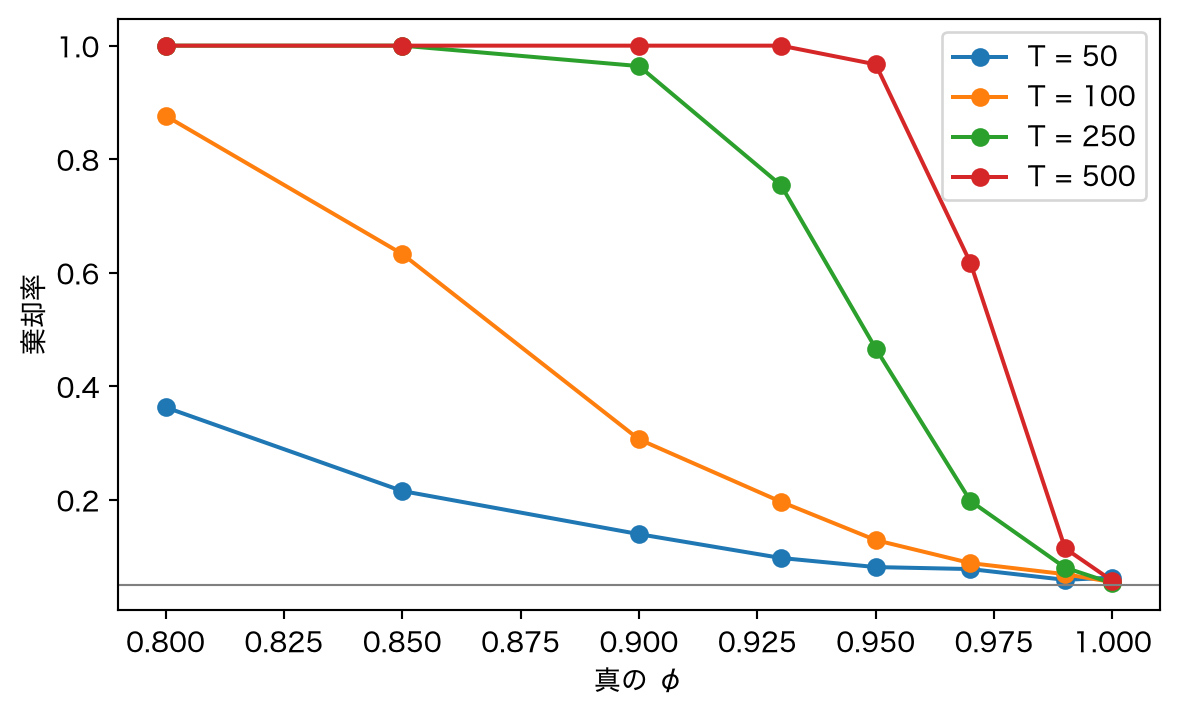
真の \(\phi\) を 1 に近づけていったとき、5% 水準で \(H_0\) を棄却できる割合(検出力)をシミュレーションで調べる。
コード
phis = np.array([0.80, 0.85, 0.90, 0.93, 0.95, 0.97, 0.99, 1.00])
fig, ax = plt.subplots()
for T in [50, 100, 250, 500]:
    power = []
    for phi in phis:
        e = rng.standard_normal((2000, T))
        y = np.zeros_like(e)
        for t in range(1, T):
            y[:, t] = phi * y[:, t - 1] + e[:, t]
        power.append((df_tau(y) < -2.86).mean())
    ax.plot(phis, power, marker="o", label=f"T = {T}")
ax.axhline(0.05, color="gray", lw=0.8)
ax.set_xlabel("真の φ")
ax.set_ylabel("棄却率")
ax.legend()
plt.show()
\(T = 100\) で \(\phi = 0.95\) だと、定常であるのに大半のケースで棄却できない。 「棄却できなかった」ことは「単位根がある」ことの証拠にはならない。
KPSS 検定と組み合わせる
KPSS 検定は仮説の向きが逆で、定常性を帰無仮説にする。両方を行うと判断しやすい。
| 棄却 |
棄却しない |
定常 |
| 棄却しない |
棄却 |
単位根あり |
| 棄却しない |
棄却しない |
データが足りず判断できない |
| 棄却 |
棄却 |
構造変化や長期記憶などを疑う |
API で試す(準備中)
この検定は api.noisymoon.jp から呼び出せるようにする予定。
POST /v1/tests/adf
{
  "series": [0.12, 0.35, 0.10, ...],
  "regression": "c",
  "autolag": "AIC"
}
参考文献
- Dickey, D. A. and Fuller, W. A. (1979). Distribution of the estimators for autoregressive time series with a unit root. JASA, 74, 427–431.
- Said, S. E. and Dickey, D. A. (1984). Testing for unit roots in autoregressive-moving average models of unknown order. Biometrika, 71, 599–607.
- MacKinnon, J. G. (2010). Critical values for cointegration tests. Queen’s Economics Department Working Paper No. 1227.
- Hamilton, J. D. (1994). Time Series Analysis. Princeton University Press, Ch. 17.