\(
\newcommand{\E}{\mathbb{E}}
\newcommand{\Var}{\operatorname{Var}}
\newcommand{\Cov}{\operatorname{Cov}}
\newcommand{\Prob}{\mathbb{P}}
\newcommand{\R}{\mathbb{R}}
\newcommand{\N}{\mathbb{N}}
\newcommand{\iid}{\overset{\text{i.i.d.}}{\sim}}
\newcommand{\dto}{\xrightarrow{d}}
\newcommand{\pto}{\xrightarrow{p}}
\newcommand{\diff}{\mathop{}\!\mathrm{d}}
\)
この記事の証明は下書きで、査読・編集の前の段階です。
このツールの使い方
必要なデータ
| 観測 \(y_1,\dots,y_T\) |
長さ \(T\) の数値の列(多変量なら各時点が長さ \(p\) の配列) |
欠測は null。一部の成分だけの欠測も可 |
| 状態遷移行列 \(F\) |
\(m\times m\) |
ローカルレベルモデルでは不要 |
| 観測行列 \(H\) |
\(p\times m\) |
〃 |
| 状態ノイズの共分散 \(Q\) |
\(m\times m\)(半正定値) |
〃。特異でもよい |
| 観測ノイズの共分散 \(R\) |
\(p\times p\)(半正定値) |
〃 |
| 初期状態 \(x_0\)、\(P_0\) |
長さ \(m\)、\(m\times m\) |
省略すると近似散漫初期化(\(P_0=10^6I\)) |
前提条件
- 線形・ガウス:状態と観測が一次式でつながり、ノイズは正規分布で、互いに・時点間で独立。
- 行列は時間によらない(時変のモデルは未対応)。
- 予測誤差の共分散 \(S_t=HP_{t\mid t-1}H^\top+R\) が正則であること(観測されている成分について)。\(R\) を正定値にすれば必ず満たされる。
- 行列を未知母数として推定するのは、今のところローカルレベルモデル(2 つの分散)だけ。
出力する値
predicted.mean, predicted.cov |
1 期先予測 \(x_{t\mid t-1}=E[x_t\mid y_{1:t-1}]\) とその共分散 \(P_{t\mid t-1}\) |
filtered.mean, filtered.cov |
フィルタ \(x_{t\mid t}=E[x_t\mid y_{1:t}]\) と \(P_{t\mid t}\) |
smoothed.mean, smoothed.cov |
平滑化 \(x_{t\mid T}=E[x_t\mid y_{1:T}]\) と \(P_{t\mid T}\) |
innovation, innovation_cov |
予測誤差 \(v_t=y_t-Hx_{t\mid t-1}\) と \(S_t\) |
loglik, loglik_obs |
対数尤度(予測誤差分解)とその各期の寄与 |
forecast |
次の期の予測 \(x_{T+1\mid T}\) と共分散 |
ローカルレベル:params, level, aic |
推定した 2 つの分散、水準のフィルタ・平滑化と標準偏差、AIC |
モデル
\[
x_{t+1}=Fx_t+w_t,\quad w_t\sim N(0,Q),\qquad
y_t=Hx_t+v_t,\quad v_t\sim N(0,R),\qquad
x_1\sim N(x_0,P_0),
\] \(w_t, v_t, x_1\) はすべて互いに独立とする。目標は、観測 \(y_{1:t}=(y_1,\dots,y_t)\) を与えたときの状態 \(x_t\) の条件付き分布を、\(t\) について順に計算することである。 すべてが正規分布なので、条件付き分布も正規分布になり、平均と共分散だけを追えばよい。
補題:多変量正規分布の条件付き分布
\[
\begin{pmatrix}a\\ b\end{pmatrix}\sim N\left(\begin{pmatrix}\mu_a\\ \mu_b\end{pmatrix},\begin{pmatrix}\Sigma_{aa}&\Sigma_{ab}\\ \Sigma_{ba}&\Sigma_{bb}\end{pmatrix}\right),\ \Sigma_{bb}\ \text{正則}
\ \Longrightarrow\
a\mid b\sim N\big(\mu_a+\Sigma_{ab}\Sigma_{bb}^{-1}(b-\mu_b),\ \Sigma_{aa}-\Sigma_{ab}\Sigma_{bb}^{-1}\Sigma_{ba}\big).
\]
証明(概略). \(K=\Sigma_{ab}\Sigma_{bb}^{-1}\)、\(e=a-\mu_a-K(b-\mu_b)\) とおくと、\(\Cov(e,b)=\Sigma_{ab}-K\Sigma_{bb}=0\)。 \((e,b)\) は同時正規なので、無相関から独立。よって \(a=\mu_a+K(b-\mu_b)+e\) の、\(b\) を与えたときの分布は、平均 \(\mu_a+K(b-\mu_b)\)、共分散 \(\Var(e)=\Sigma_{aa}-K\Sigma_{ba}\) の正規分布。\(\square\)
定理 1:フィルタ(予測と更新)
\(x_t\mid y_{1:t-1}\sim N(x_{t\mid t-1},P_{t\mid t-1})\) とする。\(S_t=HP_{t\mid t-1}H^\top+R\)、\(K_t=P_{t\mid t-1}H^\top S_t^{-1}\)、\(v_t=y_t-Hx_{t\mid t-1}\) とおくと
- 更新:\(x_t\mid y_{1:t}\sim N(x_{t\mid t},P_{t\mid t})\)、 \(x_{t\mid t}=x_{t\mid t-1}+K_tv_t\)、\(P_{t\mid t}=P_{t\mid t-1}-K_tS_tK_t^\top\)
- 予測:\(x_{t+1\mid t}=Fx_{t\mid t}\)、\(P_{t+1\mid t}=FP_{t\mid t}F^\top+Q\)
証明(概略). \(y_{1:t-1}\) を条件にしたとき、\((x_t,y_t)\) は同時正規で、 \(\Cov(x_t,y_t)=P_{t\mid t-1}H^\top\)、\(\Var(y_t)=S_t\)(\(v_t\) は \(x_t\) と \(y_{1:t-1}\) に独立)。補題 1 を \(a=x_t\)、\(b=y_t\) に当てはめると更新式を得る。 予測式は \(x_{t+1}=Fx_t+w_t\) で \(w_t\) が \(y_{1:t}\) と独立であることから。\(x_1\) の分布が仮定から正規なので、帰納法で全時点に成り立つ。\(\square\)
欠測. 時点 \(t\) で観測されている成分の添字集合を \(W\) とすると、\(H,R,y_t\) をそれぞれ \(H_W, R_{WW}, y_{t,W}\) に置き換えれば同じ議論が成り立つ。全成分が欠測なら更新をせず \(x_{t\mid t}=x_{t\mid t-1}\)。
定理 2:尤度(予測誤差分解)
\[
\log p(y_{1:T})=\sum_{t=1}^T\log p(y_t\mid y_{1:t-1})
=-\frac12\sum_{t=1}^T\Big(p_t\log 2\pi+\log\det S_t+v_t^\top S_t^{-1}v_t\Big),
\] \(p_t\) は時点 \(t\) で観測された成分の数。
証明. 左の等号は条件付き確率の連鎖律。定理 1 の証明から \(y_t\mid y_{1:t-1}\sim N(Hx_{t\mid t-1},S_t)\) なので、正規密度の対数を書けば右の等号。\(\square\)
初期分布を「情報なし」に近づけるため \(P_0=\kappa I\)(\(\kappa=10^6\))とする近似散漫初期化では、最初の数期の \(S_t\) が \(\kappa\) に支配されて尤度が不自然に小さくなるので、状態の次元 \(m\) 期分を尤度から除く(statsmodels と同じ約束)。
定理 3:平滑化
\(L_t=F(I-K_tH)\) とし、\(r_T=0\)、\(N_T=0\) から \(t=T,\dots,1\) の順に \[
r_{t-1}=H^\top S_t^{-1}v_t+L_t^\top r_t,\qquad N_{t-1}=H^\top S_t^{-1}H+L_t^\top N_tL_t
\] を計算すると、 \[
x_{t\mid T}=x_{t\mid t-1}+P_{t\mid t-1}r_{t-1},\qquad P_{t\mid T}=P_{t\mid t-1}-P_{t\mid t-1}N_{t-1}P_{t\mid t-1}.
\]
証明(概略). 予測誤差 \(v_t,\dots,v_T\) は互いに独立で、\(y_{1:t-1}\) とも独立(イノベーション)。\(y_{1:T}\) と \((y_{1:t-1},v_{t:T})\) は同じ情報なので、補題 1 を \(b=(v_t,\dots,v_T)\) に使うと \[
x_{t\mid T}=x_{t\mid t-1}+\sum_{j=t}^T\Cov(x_t,v_j)S_j^{-1}v_j .
\] 状態の予測誤差 \(e_j=x_j-x_{j\mid j-1}\) は \(e_{j+1}=L_je_j+(\text{ノイズ項})\) を満たすので、\(\Cov(x_t,v_j)=P_{t\mid t-1}L_t^\top\cdots L_{j-1}^\top H^\top\)。 これを代入すると和は \(P_{t\mid t-1}r_{t-1}\) にまとまり、\(r\) の再帰式が得られる。共分散も同様に補題 1 の共分散の式から \(N\) の再帰が得られる。\(\square\)
この形は、よく知られた RTS(Rauch–Tung–Striebel)平滑化 \(x_{t\mid T}=x_{t\mid t}+J_t(x_{t+1\mid T}-x_{t+1\mid t})\)、\(J_t=P_{t\mid t}F^\top P_{t+1\mid t}^{-1}\) と同値だが、\(P_{t+1\mid t}\) の逆行列を使わないので、\(Q\) が特異で \(P_{t+1\mid t}\) が退化する場合(ノイズのない状態成分がある場合)でも計算できる。
数値計算の注意:Joseph 形式
定理 1 の \(P_{t\mid t}=P_{t\mid t-1}-K_tS_tK_t^\top\) は、近似散漫初期化のように \(P_{t\mid t-1}\) が巨大なとき、大きな数どうしの引き算で桁落ちする。 API では代わりに、代数的に同値な Joseph 形式 \[
P_{t\mid t}=(I-K_tH)P_{t\mid t-1}(I-K_tH)^\top+K_tRK_t^\top
\] を使っている(両辺を展開し \(K_t=P_{t\mid t-1}H^\top S_t^{-1}\) を代入すれば一致する)。半正定値の和の形なので、丸め誤差で負の分散が出ることもない。 \(4\) 次元の状態・\(3\) 次元の観測・\(P_0=10^6I\) の例で 50 桁の多倍長計算と比べると、フィルタの誤差は通常の形で約 \(3\times10^{-4}\)、Joseph 形式で約 \(3\times10^{-10}\) だった。
ローカルレベルモデル
\[
y_t=\mu_t+\varepsilon_t,\ \varepsilon_t\sim N(0,\sigma^2_\varepsilon),\qquad \mu_{t+1}=\mu_t+\eta_t,\ \eta_t\sim N(0,\sigma^2_\eta).
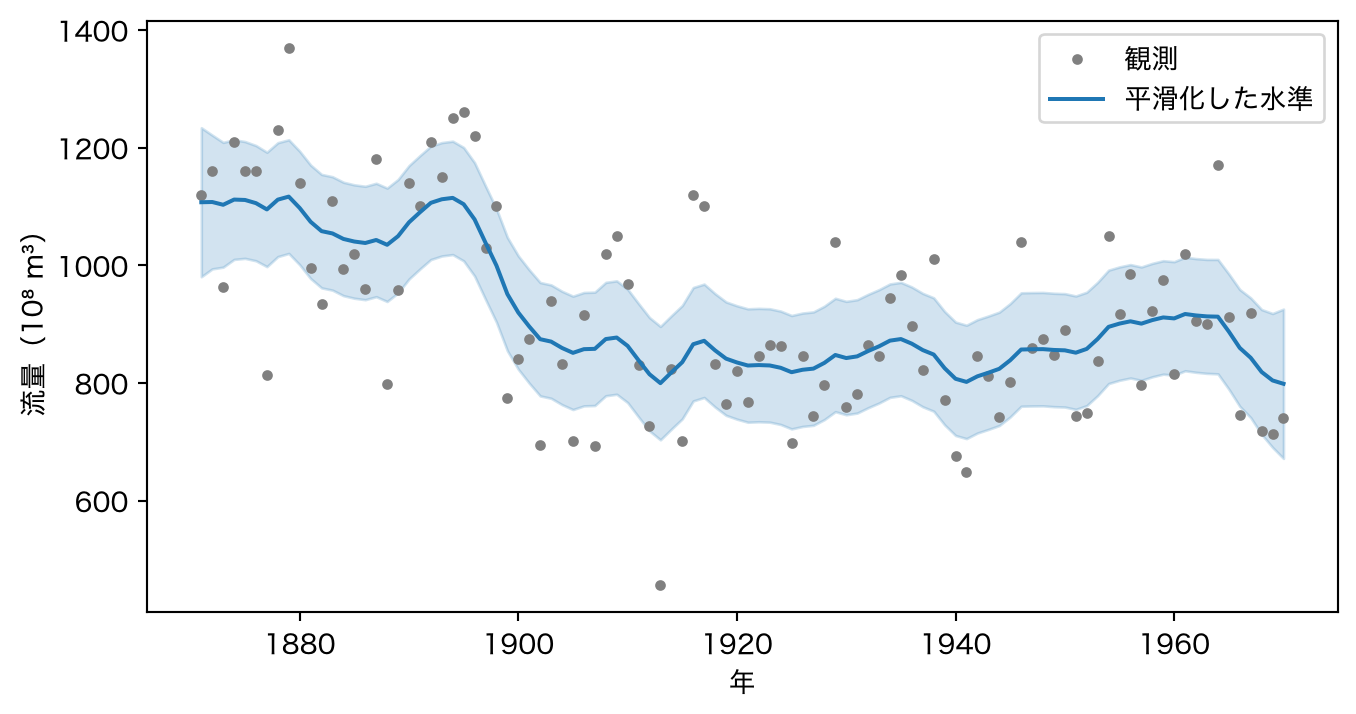
\] \(F=H=1\)、\(Q=\sigma^2_\eta\)、\(R=\sigma^2_\varepsilon\) の状態空間モデルで、ゆっくり動く水準+観測ノイズを表す最も簡単なモデル。 信号対雑音比 \(q=\sigma^2_\eta/\sigma^2_\varepsilon\) が大きいほど、フィルタは直近の観測を重く見る。
2 つの分散は、定理 2 の尤度を最大にする値として推定する(対数分散について Nelder–Mead 法で最大化。初期化は近似散漫で、最初の 1 期は尤度から除く)。
コード
import numpy as np
import matplotlib.pyplot as plt
import statsmodels.api as sm

plt.rcParams["font.family"] = ["Hiragino Sans", "sans-serif"]
nile = sm.datasets.nile.load_pandas().data
years, y = nile["year"].to_numpy(), nile["volume"].to_numpy()
from scipy.optimize import minimize

uc = sm.tsa.UnobservedComponents(y, "llevel")
# statsmodels の既定の最適化は最大点の少し手前で止まるので、厳しい条件で最適化し直す
negll = lambda lp: -uc.loglike(np.exp(lp))
opt = minimize(negll, np.log(uc.fit(disp=False).params), method="Nelder-Mead",
               options={"xatol": 1e-12, "fatol": 1e-14, "maxiter": 20000})
fit = uc.smooth(np.exp(opt.x))
level = fit.smoothed_state[0]
sd = np.sqrt(fit.smoothed_state_cov[0, 0])
fig, ax = plt.subplots(figsize=(8, 4))
ax.plot(years, y, ".", color="gray", label="観測")
ax.plot(years, level, color="C0", label="平滑化した水準")
ax.fill_between(years, level - 2 * sd, level + 2 * sd, color="C0", alpha=0.2)
ax.set_xlabel("年")
ax.set_ylabel("流量(10⁸ m³)")
ax.legend()
plt.show()
print(f"σ²_ε = {fit.params[0]:.1f}, σ²_η = {fit.params[1]:.1f}, 対数尤度 = {fit.llf:.3f}")
σ²_ε = 15108.3, σ²_η = 1463.5, 対数尤度 = -632.538
Durbin and Koopman (2012) の 2.10 節では \(\hat\sigma^2_\varepsilon=15099\)、\(\hat\sigma^2_\eta=1469.1\) となっている。 ここでの値(\(15108\)、\(1464\))との小さな差は、本が厳密な散漫初期化を使い、ここでは近似散漫初期化(\(P_0=10^6\)、最初の 1 期を除外)を使っていることによると考えられる。 API の POST /v1/statespace/local-level は、このデータで上と同じ最大点(相対 \(10^{-4}\) 以内)に収束することをテストで確認している。 一方、statsmodels の既定の fit() は、この例では尤度がわずかに低い点(\(\hat\sigma^2_\eta\approx1479\))で止まる。尤度の山が平らなので、推定値の数値には最適化の止め方の影響が出やすい。
試してみる
系列を貼り付けると、ローカルレベルモデルを推定して平滑化した水準を描く(無料・500 点まで)。
行列を自分で指定する一般のモデルは POST /v1/statespace/kalman で使える。
# 位置と速度を状態にもつ等速度モデル(観測は位置だけ)
dt = 1.0
body = {
    "y": list(positions),                      # 欠測は None
    "F": [[1, dt], [0, 1]],
    "H": [[1, 0]],
    "Q": [[dt**3 / 3, dt**2 / 2], [dt**2 / 2, dt]],
    "R": [[0.5]],
}                                              # x0, P0 を省略すると近似散漫初期化
r = requests.post("https://api.noisymoon.jp/v1/statespace/kalman", headers=H, json=body).json()
r["smoothed"]["mean"], r["loglik"]
参考文献
- Durbin, J. and Koopman, S. J. (2012). Time Series Analysis by State Space Methods, 2nd ed. Oxford University Press.(4.3 節 フィルタ、4.4 節 平滑化、7.2 節 尤度)
- Kalman, R. E. (1960). A new approach to linear filtering and prediction problems. Journal of Basic Engineering, 82, 35–45.
- Rauch, H. E., Tung, F. and Striebel, C. T. (1965). Maximum likelihood estimates of linear dynamic systems. AIAA Journal, 3, 1445–1450.
- Bucy, R. S. and Joseph, P. D. (1968). Filtering for Stochastic Processes with Applications to Guidance. Wiley.(Joseph 形式)